~/blog/2026
DDIA Chapter 12: The Future of Data SystemsDDIA Chương 12: The Future of Data Systems

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 12: The Future of Data Systems.
Chapter 11 closed with batch and stream processing being two answers to the same question. This last chapter takes a step back from any single technique and asks something bigger: now that we’ve seen replication, partitioning, transactions, consensus, batch and stream processing — how do all these pieces actually fit together in a real system, and what do we, as the people building them, owe the people who end up depending on them?
Unbundling the database: small tools instead of one big one
The first big idea ties directly back to something I wrote about twice already. Chapter 10 opened with the Unix philosophy — small tools, each doing one thing, chained together with pipes. Chapter 11 showed change data capture turning every database write into an event that independent systems could subscribe to. This chapter puts the two together into a genuinely appealing idea: instead of one database trying to be good at everything — transactions, full-text search, caching, analytics, all bundled into a single product — you can unbundle it into several small, specialized tools, each excellent at one job, kept in sync by a shared stream of events.
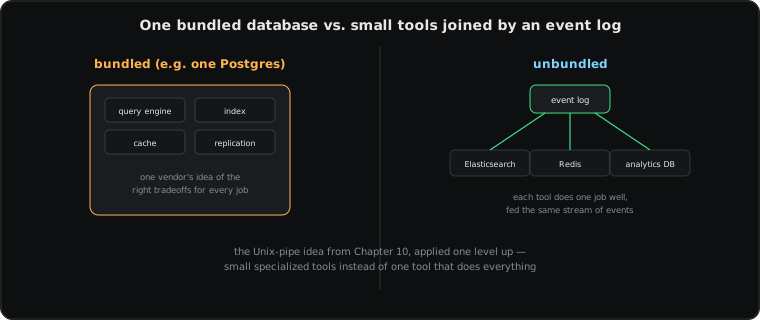
A single “batteries included” database like Postgres has to make one set of tradeoffs and hope they’re good enough for every use case its users throw at it. An unbundled setup instead lets you pick the best specialized tool for each job — Elasticsearch for full-text search, Redis for a fast cache, a dedicated analytics database for reporting — and feed all of them from the same underlying stream of events, so they never drift out of sync with each other or with the source of truth. The tradeoff is real too: you’re now operating several systems instead of one, and you’ve traded a single vendor’s tested defaults for your own responsibility to wire them together correctly.
Correctness doesn’t have to mean waiting for everyone to agree
The second idea revisits something Chapter 9 already showed was expensive: getting every node to agree before proceeding. This chapter makes a subtler point — you don’t always need that level of agreement to be correct, if you design the ends of the system carefully instead of relying entirely on the middle. This is the end-to-end argument: a guarantee is only as good as the point where it’s actually checked, so instead of trying to make every layer of infrastructure in between perfectly reliable, you put the real correctness check at the boundary that actually matters — often right where a request enters or leaves your system.
A concrete version of this: instead of relying purely on the network or the database to prevent a duplicate request (say, a user double-clicking “buy now”), the client can generate a unique request ID up front and the server can simply refuse to process the same ID twice — a small, cheap check at the true edge of the system, rather than an expensive guarantee threaded through every layer underneath it. It’s a genuinely freeing idea after a whole book about how unreliable networks and clocks are: you don’t have to fix every layer, you just have to make sure the one check that actually matters is in the right place.
The part of the chapter that isn’t really about engineering at all
The last section is the one I found most unexpected, because it isn’t about mechanics at all — it’s about responsibility. The book is blunt that the same techniques covered in this whole book — collecting data, deriving insights from it, predicting behavior from it — can be used to build a genuinely useful recommendation system, or to build a surveillance tool, or a system that quietly discriminates against people based on patterns in data that reflect historical unfairness rather than anything about a specific individual. A credit-scoring or hiring algorithm trained on biased historical data doesn’t magically become neutral just because it’s “just following the data” — it can bake in and even amplify exactly the same bias, at a scale and speed a human process never could.
The book’s phrase for this that stuck with me: data, once collected, doesn’t just sit there neutrally — it becomes a liability, something that can be subpoenaed, breached, repurposed for things the people it describes never agreed to. The practical takeaway isn’t “don’t build data systems,” it’s “the engineer who decides what gets logged, retained, and fed into a model is making a real decision with real consequences for real people, whether or not they think of it that way.”
Closing the loop on the whole book
Looking back across everything from reliability and scalability through this final chapter, the shape of the whole book finally makes sense as one connected argument rather than twelve separate topics: data models and storage engines decide how a single machine holds data honestly; replication and partitioning spread that honesty across many machines; transactions, distributed-systems trouble, and consensus keep that honesty intact when things fail; and batch and stream processing turn that honest data into something useful. This chapter’s real closing point is that getting all of that technically right is necessary, but it was never sufficient on its own — the last question always has to be what you’re actually building it for, and who has to live with the answer.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 12: The Future of Data Systems.
Chương 11 kết thúc với việc batch và stream processing là hai câu trả lời cho cùng một câu hỏi. Chương cuối này lùi lại khỏi bất kỳ kỹ thuật đơn lẻ nào và hỏi một điều lớn hơn: giờ đã thấy replication, partitioning, transaction, consensus, batch và stream processing — tất cả những mảnh này thực sự khớp với nhau ra sao trong một hệ thống thật, và chúng ta, những người xây dựng chúng, nợ những người cuối cùng phụ thuộc vào chúng điều gì?
Unbundling database: nhiều công cụ nhỏ thay vì một công cụ lớn
Ý tưởng lớn đầu tiên nối thẳng về thứ tôi đã viết hai lần rồi. Chương 10 mở đầu bằng triết lý Unix — công cụ nhỏ, mỗi cái làm một việc, nối lại bằng pipe. Chương 11 cho thấy change data capture biến mỗi lượt ghi database thành một sự kiện mà các hệ thống độc lập có thể subscribe vào. Chương này gộp hai thứ lại thành một ý tưởng thực sự hấp dẫn: thay vì một database cố gắng giỏi mọi thứ — transaction, tìm kiếm full-text, cache, phân tích, tất cả gộp vào một sản phẩm duy nhất — bạn có thể unbundle (tháo rời) nó thành vài công cụ nhỏ, chuyên biệt, mỗi cái xuất sắc ở một việc, được giữ đồng bộ bởi một luồng sự kiện chung.
Một database “trọn gói” như Postgres phải đưa ra một bộ đánh đổi duy nhất và hy vọng nó đủ tốt cho mọi use case người dùng ném vào nó. Một hệ thống unbundled thay vào đó cho phép bạn chọn công cụ chuyên biệt tốt nhất cho từng việc — Elasticsearch cho tìm kiếm full-text, Redis cho cache nhanh, một database phân tích riêng cho báo cáo — và cho tất cả chúng ăn từ cùng một luồng sự kiện nền, để chúng không bao giờ lệch pha với nhau hay với nguồn sự thật gốc. Đánh đổi cũng có thật: giờ bạn đang vận hành nhiều hệ thống thay vì một, và bạn đã đổi các mặc định đã được một nhà cung cấp kiểm chứng lấy trách nhiệm của chính mình trong việc nối chúng lại đúng cách.
Đúng đắn không nhất thiết phải có nghĩa là chờ mọi người đồng ý
Ý tưởng thứ hai quay lại một điều Chương 9 đã cho thấy là tốn kém: khiến mọi node đồng ý trước khi tiếp tục. Chương này đưa ra một điểm tinh vi hơn — bạn không phải lúc nào cũng cần mức độ đồng thuận đó để đúng đắn, nếu bạn thiết kế cẩn thận hai đầu của hệ thống thay vì hoàn toàn dựa vào phần giữa. Đây là end-to-end argument (luận điểm đầu-cuối): một đảm bảo chỉ tốt bằng đúng điểm nó thực sự được kiểm tra, nên thay vì cố làm cho mọi tầng hạ tầng ở giữa hoàn toàn đáng tin cậy, bạn đặt lần kiểm tra đúng đắn thật sự ở ranh giới thực sự quan trọng — thường chính là nơi một request đi vào hoặc rời khỏi hệ thống của bạn.
Một phiên bản cụ thể của điều này: thay vì hoàn toàn dựa vào mạng hay database để ngăn một request bị trùng (ví dụ, người dùng bấm “mua ngay” hai lần), client có thể tạo sẵn một request ID duy nhất từ đầu, và server chỉ đơn giản từ chối xử lý cùng một ID hai lần — một lần kiểm tra nhỏ, rẻ, ở đúng ranh giới thật sự của hệ thống, thay vì một đảm bảo tốn kém được luồn qua mọi tầng bên dưới nó. Đây là một ý tưởng thực sự giải phóng sau cả một cuốn sách nói về việc mạng và đồng hồ không đáng tin cậy tới mức nào: bạn không cần sửa mọi tầng, bạn chỉ cần đảm bảo đúng một lần kiểm tra thực sự quan trọng nằm ở đúng chỗ.
Phần của chương không hề nói về kỹ thuật chút nào
Phần cuối là phần tôi thấy bất ngờ nhất, vì nó hoàn toàn không nói về cơ chế — nó nói về trách nhiệm. Cuốn sách nói thẳng rằng đúng những kỹ thuật được nói tới trong cả cuốn sách này — thu thập dữ liệu, rút ra insight từ nó, dự đoán hành vi từ nó — có thể được dùng để xây một hệ thống gợi ý thực sự hữu ích, hoặc để xây một công cụ giám sát, hoặc một hệ thống âm thầm phân biệt đối xử với con người dựa trên các pattern trong dữ liệu phản ánh sự bất công lịch sử hơn là bất cứ điều gì về một cá nhân cụ thể. Một thuật toán chấm điểm tín dụng hay tuyển dụng được huấn luyện trên dữ liệu lịch sử thiên lệch không tự nhiên trở nên trung lập chỉ vì nó “chỉ đang theo dữ liệu” — nó có thể đóng khung và thậm chí khuếch đại đúng sự thiên lệch đó, ở quy mô và tốc độ mà một quy trình con người chưa bao giờ có thể đạt tới.
Câu cuốn sách dùng cho điều này khiến tôi nhớ mãi: dữ liệu, một khi đã được thu thập, không chỉ nằm đó trung lập — nó trở thành một gánh nặng trách nhiệm, thứ có thể bị triệu tập ra tòa, bị rò rỉ, bị tái sử dụng cho những việc mà những người nó mô tả chưa bao giờ đồng ý. Bài học thực tế không phải là “đừng xây hệ thống dữ liệu,” mà là “kỹ sư quyết định cái gì được log lại, được giữ lại, và được đưa vào một model đang đưa ra một quyết định thật, với hậu quả thật cho những con người thật, dù họ có nghĩ theo cách đó hay không.”
Khép lại toàn bộ cuốn sách
Nhìn lại tất cả từ reliability và scalability cho tới chương cuối này, hình dạng của cả cuốn sách cuối cùng cũng hợp lý như một luận điểm liền mạch thay vì mười hai chủ đề rời rạc: data model và storage engine quyết định cách một máy đơn lẻ giữ dữ liệu một cách trung thực; replication và partitioning trải sự trung thực đó ra nhiều máy; transaction, rắc rối hệ phân tán, và consensus giữ sự trung thực đó nguyên vẹn khi có sự cố; và batch cùng stream processing biến dữ liệu trung thực đó thành thứ hữu ích. Điểm khép lại thực sự của chương này là làm đúng tất cả những điều đó về mặt kỹ thuật là cần thiết, nhưng chưa bao giờ là đủ tự thân — câu hỏi cuối cùng luôn phải là bạn thực sự đang xây nó để làm gì, và ai sẽ phải sống chung với câu trả lời đó.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.