~/blog/2026
DDIA Chapter 5: ReplicationDDIA Chương 5: Replication

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 5: Replication.
This chapter answers a question I’d always taken for granted without really thinking through: how does a website or app keep working when one of the machines behind it just… dies? Physical machines fail — hard disks wear out, power supplies blow, someone in a data center trips over the wrong cable. The obvious fix is to keep more than one copy of your data on more than one machine, so if one dies, another one already has the data ready to go. That’s replication, and it sounds simple in one sentence, but the chapter spends its length on everything that makes it genuinely tricky to do safely — and once I worked through it, a bunch of things I used to lump together as “just high availability stuff” turned out to be distinct, specific problems.
Failure isn’t just “on or off”
The first thing that reframed this chapter for me: I used to picture “a machine failing” as a light switch — it’s either fine or it’s dead. Real failures are messier than that. A machine can be slow instead of dead. A network cable can be flaky, dropping some messages but not all. A machine can be perfectly healthy but unreachable from certain other machines due to a network hiccup, while still being reachable from others — this is called a partial failure, and it’s genuinely confusing because from any single other machine’s point of view, “that server is slow to respond” and “that server is dead” look identical until you wait long enough to be sure.
This matters because a system that only knows how to handle the clean, easy case — “the machine crashed and restarted” — falls apart the first time it hits one of these messier, more ambiguous situations. So the real goal of “high availability” isn’t “prevent every possible failure” (you can’t — hardware breaks, that’s just physics), it’s “design the system so that when something breaks, the rest of it can keep going anyway.” Which immediately implies two rules: no single machine should be the only copy of any piece of data, and no single machine should be the only one allowed to accept new writes forever.
Three ways to organize your copies
Given that you’re going to keep several copies of the data, the next question is: who’s allowed to write to which copy, and how do the copies stay in sync? The book walks through three common setups, and I found it much easier to remember them by thinking about who’s “in charge” of writes in each one:
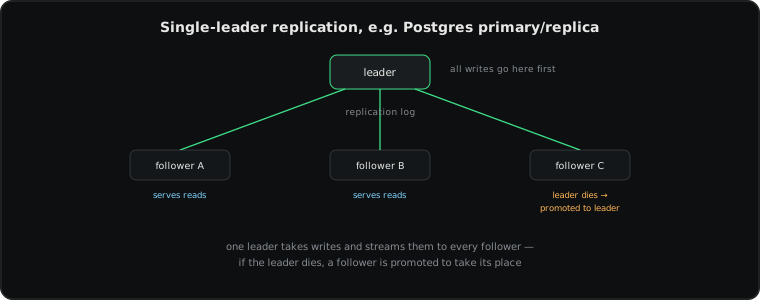
- Single-leader — think of a classroom with one teacher writing notes on the board, and every student just copying down whatever the teacher writes. One machine (the “leader”) is the only one allowed to accept new writes; every other machine (a “follower”) just receives a copy of everything the leader does, in order. This is easy to reason about — there’s never any doubt about which copy is the “real,” most current one — but it has an obvious weak point: if the teacher (the leader) suddenly leaves, someone has to step up and take over, and until that happens, nobody can write anything new.
- Multi-leader — instead of one teacher, imagine several classrooms in different cities, each with its own teacher, and the teachers periodically compare notes with each other to stay in sync. Several machines can all accept writes at the same time (often used when you have offices or users in different countries, so each region can write to a nearby copy instead of one far away). The catch: if two teachers in two different cities write conflicting things onto their boards before comparing notes, someone has to decide which version wins, or how to merge them.
- Leaderless — there’s no teacher at all; any student can just shout out an update, and everyone tries to make sure enough of the group has heard the latest version. Concretely, the client talks directly to several copies at once for both reads and writes, and as long as enough of them agree (a “quorum” — think of it as “enough votes to be confident”), the system considers the operation successful. This avoids ever having a single leader that can fail, but it pushes the hard problem onto figuring out, after the fact, when different copies have quietly drifted out of sync with each other.
What I found genuinely useful here isn’t memorizing the three names — it’s noticing that none of them “solves” the hard problem, they just move it somewhere else. Single-leader moves it to “how do we safely hand off leadership when the leader dies.” Multi-leader moves it to “how do we merge two conflicting versions of the truth.” Leaderless moves it to “how does anyone know if they just read a stale copy.”
When the leader dies, theory meets a genuinely messy reality
This was the part of the chapter that felt the least like abstract theory and the most like real, hard-won engineering experience. “The leader dies, so promote a follower” sounds like a one-line fix, but every step of actually doing that safely has a sharp edge hiding in it:
- Figuring out the leader is actually dead, and not just briefly slow or temporarily unreachable — usually done by waiting for some timeout period with no response. Wait too short a time and you’ll trigger a false alarm every time the leader is just momentarily busy, kicking off an unnecessary and disruptive handoff. Wait too long and real outages last longer than they need to.
- Picking which follower becomes the new leader — ideally the one with the most up-to-date copy of the data, not one that’s lagging behind and would silently lose recent writes. Choosing correctly, safely, with multiple machines possibly disagreeing about who should win, is exactly the kind of problem that needs a proper “everyone agrees on one answer” protocol — which is the entire subject of the consensus algorithms covered later, in Chapter 9.
- Telling every client and every other follower about the new leader, so everyone starts sending writes to the right place going forward.
The genuinely scary failure mode here is called split brain: the old leader comes back online after being unreachable for a bit, doesn’t realize a new leader has already been promoted in its absence, and keeps right on accepting writes as if nothing happened — meanwhile so does the new leader. Now you have two machines both convinced they’re in charge, both accepting different writes, and no clean way to know which version of events is the “real” one without manually untangling the mess afterward. Kleppmann’s blunt point here, which stuck with me: there is no timeout value that is simultaneously perfectly safe and perfectly fast. You’re always picking a point on that tradeoff, not making the tradeoff disappear.
Even when nothing “fails,” copies can still lag behind
Here’s a subtler problem that has nothing to do with anything actually breaking. Followers usually replicate asynchronously — meaning the leader doesn’t wait around for every follower to confirm before telling the original writer “done, saved” — because waiting for every single copy on every single write would make everything painfully slow. But this means followers are always at least a little bit behind the leader, and that small lag can cause genuinely confusing bugs. Picture posting a comment on a website, having it save successfully, and then immediately refreshing the page — only to see the comment has vanished, because your refresh happened to read from a follower that hadn’t caught up yet. Nothing broke. The comment is safe on the leader. But from the user’s point of view, it looks exactly like data loss.
The book names a few specific promises a system can choose to make, to prevent exactly this kind of confusion:
- Read-your-writes — you should always be able to see your own recent changes immediately, even if other people’s reads are still served from a slightly-behind copy.
- Monotonic reads — once you’ve seen a piece of data, you should never see an older version of it later, which can otherwise happen if two of your reads happen to land on two different followers that aren’t equally caught up.
- Consistent prefix reads — if one event genuinely happened before another in reality, nobody should ever see them in the reverse order.
None of these come for free — each one is a specific thing an engineering team has to deliberately build (send a user’s own reads to the leader right after they write something, keep a user’s session pinned to the same follower, track which version of the data a client has already seen). Skip one, and you get a very specific, very reproducible bug that some real user will eventually stumble into.
Why this keeps pointing at Chapter 9
The thread running underneath all of this — choosing a new leader safely, avoiding split brain, agreeing on which of several conflicting writes actually “won” — is really the exact same underlying problem wearing different clothes: getting a group of machines to agree on one answer, even when some of them might be slow, crashed, or unable to talk to each other. That underlying problem has a name, consensus, and it’s serious enough to deserve its own full chapter later in the book (Chapter 9). So “high availability” isn’t really a separate topic from consensus at all — it’s consensus, applied to the one specific question that matters most when you’re keeping a system alive: who is allowed to accept writes right now?
What actually changed in how I think about this
Before this chapter, “high availability” was a vague, feel-good phrase to me — something you got by “adding more servers.” After it, I see it as a set of very concrete, very deliberate tradeoffs: how long to wait before declaring a leader dead, which specific staleness guarantees you’re willing to promise your users, and how you’ll detect and untangle conflicting writes when they happen. None of that comes from the failure-free, everything-working case — it all comes from deliberately planning for the mess.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 5: Replication.
Chương này trả lời một câu hỏi mà trước giờ tôi cứ mặc nhiên coi là hiển nhiên mà chưa thực sự nghĩ kỹ: làm sao một website hay app vẫn hoạt động khi một trong những máy đứng sau nó đột nhiên… chết? Máy móc vật lý thì sẽ hỏng — ổ cứng mòn, nguồn điện cháy, ai đó trong trung tâm dữ liệu vấp phải nhầm dây cáp. Cách sửa hiển nhiên là giữ nhiều hơn một bản sao dữ liệu trên nhiều hơn một máy, để nếu một máy chết, máy khác đã có sẵn dữ liệu, sẵn sàng phục vụ ngay. Đó là replication, nghe qua thì đơn giản trong đúng một câu, nhưng cả chương dành phần lớn nội dung cho mọi thứ khiến việc này thực sự khó làm cho an toàn — và sau khi đọc kỹ, một loạt thứ tôi từng gộp chung thành “mấy cái liên quan tới high availability” hóa ra lại là những vấn đề riêng biệt, rất cụ thể.
Failure không chỉ đơn giản là “bật hoặc tắt”
Điều đầu tiên khiến tôi nhìn lại cả chương: trước đây tôi hình dung “một máy bị lỗi” giống như một công tắc điện — hoặc là ổn, hoặc là chết hẳn. Failure thật thì lộn xộn hơn nhiều. Một máy có thể chậm thay vì chết hẳn. Một đường mạng có thể chập chờn, làm rớt vài message nhưng không phải tất cả. Một máy có thể hoàn toàn khỏe mạnh nhưng không tới được từ một số máy khác do trục trặc mạng, trong khi vẫn tới được từ những máy khác — gọi là partial failure (lỗi cục bộ), và nó thực sự gây rối vì từ góc nhìn của bất kỳ máy nào khác, “server đó phản hồi chậm” và “server đó đã chết” trông giống hệt nhau cho đến khi bạn chờ đủ lâu để chắc chắn.
Điều này quan trọng vì một hệ thống chỉ biết xử lý kịch bản sạch sẽ, dễ dàng — “máy crash rồi restart lại” — sẽ sụp đổ ngay lần đầu gặp phải một trong những tình huống lộn xộn, mơ hồ hơn này. Vậy nên mục tiêu thực sự của “high availability” không phải là “ngăn chặn mọi failure có thể xảy ra” (bạn không thể — phần cứng sẽ hỏng, đó là vật lý), mà là “thiết kế hệ thống sao cho khi có gì đó hỏng, phần còn lại vẫn tiếp tục hoạt động được.” Điều này kéo theo ngay hai quy tắc: không một máy nào nên là bản sao duy nhất của bất kỳ mẩu dữ liệu nào, và không một máy nào nên là nơi duy nhất được phép nhận ghi mãi mãi.
Ba cách tổ chức các bản sao
Một khi đã quyết định giữ nhiều bản sao dữ liệu, câu hỏi tiếp theo là: ai được phép ghi vào bản sao nào, và các bản sao giữ đồng bộ với nhau ra sao? Cuốn sách trình bày ba cách sắp xếp phổ biến, và tôi thấy dễ nhớ hơn nhiều khi nghĩ về việc ai đang “cầm trịch” việc ghi trong từng cách:
- Single-leader — hình dung một lớp học với một giáo viên duy nhất viết ghi chú lên bảng, và mọi học sinh chỉ việc chép lại những gì giáo viên viết. Một máy (gọi là “leader”) là máy duy nhất được phép nhận lượt ghi mới; mọi máy khác (gọi là “follower”) chỉ nhận một bản sao của mọi thứ leader làm, theo đúng thứ tự. Cách này dễ suy luận — không bao giờ có nghi ngờ về việc bản sao nào mới là “thật,” cập nhật nhất — nhưng có một điểm yếu hiển nhiên: nếu giáo viên (leader) đột nhiên rời đi, phải có ai đó đứng ra thay thế, và cho tới khi điều đó xảy ra, không ai ghi được gì mới cả.
- Multi-leader — thay vì một giáo viên, hãy tưởng tượng nhiều lớp học ở nhiều thành phố khác nhau, mỗi lớp có giáo viên riêng, và các giáo viên định kỳ so sánh ghi chú với nhau để giữ đồng bộ. Nhiều máy có thể cùng nhận ghi cùng lúc (thường dùng khi bạn có văn phòng hoặc người dùng ở nhiều quốc gia, để mỗi vùng ghi vào một bản sao gần đó thay vì một bản sao ở xa). Vấn đề: nếu hai giáo viên ở hai thành phố khác nhau viết những thứ mâu thuẫn nhau lên bảng trước khi kịp so sánh ghi chú, ai đó phải quyết định phiên bản nào thắng, hoặc gộp chúng lại như thế nào.
- Leaderless — chẳng có giáo viên nào cả; học sinh nào cũng có thể hét lên một cập nhật, và mọi người cố đảm bảo đủ số đông trong nhóm đã nghe được phiên bản mới nhất. Cụ thể, client nói chuyện trực tiếp với nhiều bản sao cùng lúc cho cả đọc và ghi, và miễn là đủ số bản sao đồng ý (gọi là “quorum” — cứ nghĩ như “đủ phiếu để tự tin”), hệ thống coi thao tác đó là thành công. Cách này tránh được việc có một leader duy nhất có thể chết, nhưng đẩy vấn đề khó sang việc phải tìm ra, sau khi sự việc đã xảy ra, khi nào các bản sao khác nhau đã âm thầm lệch pha nhau.
Điều tôi thấy thực sự hữu ích ở đây không phải là học thuộc ba cái tên — mà là nhận ra không cái nào trong số đó thực sự “giải quyết” được vấn đề khó, chúng chỉ dời nó sang chỗ khác. Single-leader dời nó thành “làm sao chuyển giao quyền lãnh đạo an toàn khi leader chết.” Multi-leader dời nó thành “làm sao gộp hai phiên bản mâu thuẫn của sự thật.” Leaderless dời nó thành “làm sao ai đó biết được mình vừa đọc phải một bản sao đã cũ.”
Khi leader chết, lý thuyết đụng phải một thực tế thực sự lộn xộn
Đây là phần khiến tôi cảm thấy ít giống lý thuyết trừu tượng nhất và giống kinh nghiệm kỹ thuật thật, gian nan nhất. “Leader chết, thì thăng cấp một follower” nghe như một câu sửa đơn giản, nhưng mỗi bước để thực sự làm điều đó an toàn đều ẩn chứa một góc khuất:
- Xác định leader thực sự đã chết, chứ không chỉ chậm tạm thời hay tạm thời không tới được — thường làm bằng cách chờ một khoảng timeout không có phản hồi. Chờ quá ngắn thì bạn sẽ kích hoạt báo động giả mỗi khi leader chỉ đang bận tạm thời, gây ra một lần chuyển giao không cần thiết và gây rối. Chờ quá lâu thì sự cố thật kéo dài hơn mức cần thiết.
- Chọn follower nào trở thành leader mới — lý tưởng là follower có bản sao dữ liệu mới nhất, không phải một follower đang bị trễ và sẽ âm thầm làm mất các lượt ghi gần đây. Chọn đúng, an toàn, khi nhiều máy có thể bất đồng về việc ai nên thắng, chính xác là loại vấn đề cần một giao thức “mọi người đồng thuận về một câu trả lời” đúng nghĩa — đó chính là toàn bộ chủ đề của các thuật toán consensus được nói tới sau này, ở Chương 9.
- Báo cho mọi client và mọi follower khác biết về leader mới, để mọi người bắt đầu gửi lượt ghi tới đúng nơi kể từ đó.
Failure mode thực sự đáng sợ ở đây gọi là split brain: leader cũ quay lại online sau một thời gian không tới được, không nhận ra đã có leader mới được thăng cấp trong lúc nó vắng mặt, và cứ tiếp tục nhận ghi như chưa có chuyện gì xảy ra — trong khi leader mới cũng đang làm y hệt vậy. Giờ bạn có hai máy đều tin chắc mình đang cầm quyền, cả hai đều nhận các lượt ghi khác nhau, và không có cách nào sạch sẽ để biết phiên bản nào của sự việc mới là “thật” mà không phải gỡ rối thủ công sau đó. Quan điểm thẳng thắn của Kleppmann ở đây, điều đọng lại trong tôi: không có giá trị timeout nào vừa an toàn tuyệt đối vừa nhanh tuyệt đối cùng lúc. Bạn luôn đang chọn một điểm trên đường đánh đổi đó, chứ không phải làm cho đánh đổi đó biến mất.
Ngay cả khi không có gì “hỏng,” các bản sao vẫn có thể bị trễ
Đây là một vấn đề tinh vi hơn, chẳng liên quan gì tới việc có thứ gì thực sự bị hỏng. Follower thường replicate theo kiểu bất đồng bộ — nghĩa là leader không ngồi chờ mọi follower xác nhận trước khi báo cho người ghi ban đầu là “xong, đã lưu” — vì chờ mọi bản sao xác nhận ở mỗi lượt ghi sẽ khiến mọi thứ chậm đến khó chịu. Nhưng điều này nghĩa là follower luôn trễ hơn leader ít nhất một chút, và độ trễ nhỏ đó có thể gây ra những con bug thực sự gây bối rối. Hãy tưởng tượng bạn đăng một bình luận trên một website, nó lưu thành công, rồi bạn lập tức tải lại trang — chỉ để thấy bình luận đó biến mất, vì lần tải lại đó tình cờ đọc từ một follower chưa kịp bắt kịp. Không có gì hỏng cả. Bình luận vẫn an toàn trên leader. Nhưng từ góc nhìn của người dùng, nó trông y hệt như mất dữ liệu.
Cuốn sách gọi tên vài cam kết cụ thể một hệ thống có thể chọn để đưa ra, nhằm ngăn đúng loại bối rối này:
- Read-your-writes — bạn phải luôn thấy được thay đổi của chính mình ngay lập tức, ngay cả khi lượt đọc của người khác vẫn đang được phục vụ từ một bản sao hơi trễ.
- Monotonic reads — một khi đã thấy một mẩu dữ liệu, bạn không bao giờ nên thấy một phiên bản cũ hơn của nó sau đó, điều có thể xảy ra nếu hai lượt đọc của bạn tình cờ rơi vào hai follower không cập nhật ngang nhau.
- Consistent prefix reads — nếu một sự kiện thực sự xảy ra trước một sự kiện khác trong thực tế, không ai nên thấy chúng theo thứ tự ngược lại.
Không cái nào trong số này miễn phí — mỗi cái là một thứ cụ thể mà một team kỹ thuật phải chủ động xây dựng (gửi lượt đọc của chính người dùng về leader ngay sau khi họ ghi gì đó, giữ session của một người dùng gắn cố định với cùng một follower, theo dõi phiên bản dữ liệu nào một client đã từng thấy). Bỏ qua một cái, bạn sẽ có một con bug rất cụ thể, rất dễ tái hiện, đang chờ một người dùng thật nào đó vô tình vấp phải.
Vì sao chương này cứ liên tục hướng về Chương 9
Sợi chỉ chạy xuyên suốt bên dưới tất cả những điều này — chọn leader mới an toàn, tránh split brain, đồng thuận xem lượt ghi mâu thuẫn nào trong số nhiều lượt thực sự “thắng” — thực chất là đúng một vấn đề nền tảng khoác những bộ áo khác nhau: làm cho một nhóm máy đồng thuận về một câu trả lời, ngay cả khi một số máy có thể chậm, đã chết, hoặc không nói chuyện được với nhau. Vấn đề nền tảng đó có tên riêng, consensus, và nó nghiêm trọng đến mức xứng đáng có cả một chương riêng sau này trong sách (Chương 9). Vậy nên “high availability” thực ra không phải một chủ đề tách biệt khỏi consensus chút nào — nó chính là consensus, được áp dụng vào đúng một câu hỏi quan trọng nhất khi bạn cố giữ cho hệ thống sống: ai được phép nhận ghi ngay lúc này?
Điều thực sự thay đổi trong cách tôi nghĩ về chuyện này
Trước chương này, “high availability” với tôi là một cụm từ mơ hồ, nghe có vẻ hay ho — thứ bạn có được bằng cách “thêm nhiều server hơn.” Sau chương này, tôi nhìn nó như một tập các đánh đổi rất cụ thể, rất chủ đích: chờ bao lâu trước khi tuyên bố leader đã chết, những đảm bảo về độ “cũ” của dữ liệu nào bạn sẵn sàng hứa với người dùng, và bạn sẽ phát hiện, gỡ rối các lượt ghi mâu thuẫn ra sao khi chúng xảy ra. Không điều nào trong số đó đến từ trường hợp mọi thứ đều hoạt động trơn tru, không có failure — tất cả đều đến từ việc chủ động lên kế hoạch cho sự lộn xộn.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.