~/blog/2026
DDIA Chapter 10: Batch ProcessingDDIA Chương 10: Batch Processing

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 10: Batch Processing.
Everything from replication through consensus was about keeping data safe and correct across multiple machines. This chapter starts a new part of the book, and the question changes: given a huge pile of data that’s already sitting there safely, how do you actually compute something useful from it — a search index, a set of recommendations, a report — without waiting forever? The book calls this kind of computed output derived data, and batch processing is the first of two ways it covers for producing it.
The Unix philosophy, scaled up
The chapter’s opening example is almost embarrassingly simple, and that’s exactly the point: counting how often each word appears in a log file using nothing but classic Unix command-line tools — cat to read the file, sort to group identical words next to each other, uniq -c to count how many times each one repeats. Each of these tools does exactly one small thing, and they’re chained together with pipes, where the output of one becomes the input of the next.
What makes this example matter for the rest of the chapter is the design principle behind it: every one of these tools reads from a plain stream of text and writes to a plain stream of text, with no knowledge of what tool comes before or after it in the chain. Because the interface is so simple and uniform, you can rearrange, swap, or insert new tools into the pipeline freely. This turns out to be the exact same idea that lets modern batch processing systems combine dozens of small operations into one large computation without every piece needing to understand every other piece.
MapReduce: the same idea, spread across a thousand machines
A single Unix pipeline runs on one machine. MapReduce — the framework Google introduced and popularized, and which Hadoop later made available outside Google — takes that same “read input, transform it, group it, write output” pattern and spreads it across a whole cluster of machines, so it can chew through datasets far too large for any single machine to hold.
The map step takes the input, split across many machines, and transforms each individual record independently — in the word-count example, turning each line of text into a series of (word, 1) pairs. Then comes the shuffle: all the pairs with the same word get routed to the same machine, so that machine sees every occurrence of that one word together. Finally the reduce step takes each group and combines it into a final answer — adding up all the 1s for a given word to get its total count. Input and output at every stage lives on a distributed filesystem (Hadoop’s version is called HDFS), which is what lets the whole thing scale to datasets spread across hundreds of machines in the first place.
Where MapReduce gets genuinely clever: batch joins
Beyond simple counting, the chapter spends real time on something I hadn’t thought about before: how do you join two enormous datasets — say, a log of user activity and a separate table of user profiles — when both are too big to fit on one machine and you can’t just run a database-style join? The book covers a couple of approaches, and the tradeoff between them was a genuinely useful thing to internalize:
A sort-merge join sorts both datasets by the shared key (say, user ID) and streams through them together, matching up records as it goes — very similar in spirit to how sort groups identical words together in the Unix example, just done at a much larger scale across a cluster. A broadcast hash join instead recognizes that one of the two datasets (the smaller one, like the user-profile table) can fit entirely in memory on every machine, so it gets copied out to all of them, and each machine can then look up matches locally without needing to sort or shuffle the giant dataset at all. Which one is better depends entirely on the actual size difference between the two datasets — exactly the kind of “know your actual workload” lesson that showed up back in the Twitter timeline example too.
Why the diagram matters: not every batch system pays the same disk cost
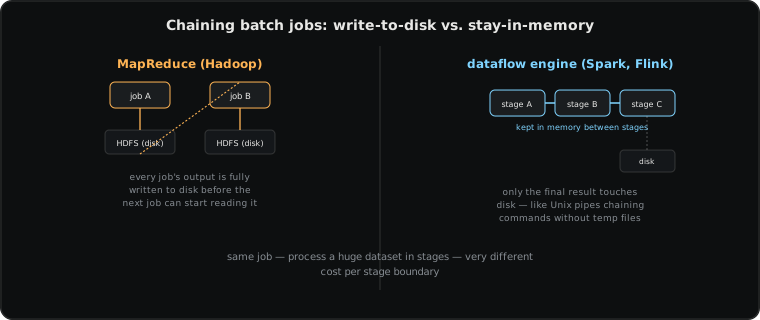
The one design choice that most shaped how batch processing evolved after the original MapReduce is exactly what the diagram above shows. Classic MapReduce chains jobs together by having each one write its complete output to the distributed filesystem before the next job is even allowed to start reading it — safe and simple, but it means a computation with five sequential steps pays for five full round-trips to disk, even though the earlier Unix pipe example never needed to touch disk at all between commands. Newer dataflow engines — Spark, Flink, Tez — fix exactly this: they keep intermediate results in memory and pipeline data directly from one processing stage to the next wherever possible, only touching disk when they genuinely have to (running out of memory, or writing the final result). This is a big part of why a Spark job doing the same work as an old-style MapReduce job can run dramatically faster: not a smarter algorithm, just far less unnecessary disk I/O between the steps.
Looking ahead, this chapter is really the “first half” of a pair — batch processing works great when you’re happy to wait for all the input to be collected before computing anything (a nightly report, reprocessing a year of logs). The next chapter tackles the opposite case: producing derived data continuously, as new events arrive one at a time, instead of waiting for a full batch to accumulate.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 10: Batch Processing.
Mọi thứ từ replication tới consensus đều nói về việc giữ dữ liệu an toàn và đúng đắn trên nhiều máy. Chương này mở ra một phần mới của cuốn sách, và câu hỏi thay đổi: với một đống dữ liệu khổng lồ đã nằm sẵn đó an toàn rồi, làm sao bạn thực sự tính ra thứ gì đó hữu ích từ nó — một search index, một danh sách gợi ý, một báo cáo — mà không phải chờ mãi mãi? Cuốn sách gọi loại kết quả được tính ra này là derived data (dữ liệu dẫn xuất), và batch processing là cách đầu tiên trong hai cách sách nói tới để tạo ra nó.
Triết lý Unix, phóng to quy mô
Ví dụ mở đầu chương đơn giản đến mức gần như buồn cười, và đó chính xác là chủ đích: đếm mỗi từ xuất hiện bao nhiêu lần trong một file log chỉ bằng các công cụ dòng lệnh Unix kinh điển — cat để đọc file, sort để gom các từ giống nhau đứng cạnh nhau, uniq -c để đếm mỗi từ lặp lại bao nhiêu lần. Mỗi công cụ này chỉ làm đúng một việc nhỏ, và chúng được nối lại bằng pipe, nơi đầu ra của công cụ này trở thành đầu vào của công cụ tiếp theo.
Điều khiến ví dụ này quan trọng cho phần còn lại của chương là nguyên tắc thiết kế đằng sau nó: mỗi công cụ trong số này đọc từ một luồng text đơn giản và ghi ra một luồng text đơn giản, không biết gì về công cụ đứng trước hay sau nó trong chuỗi. Vì interface đơn giản và thống nhất đến vậy, bạn có thể sắp xếp lại, thay thế, hoặc chèn công cụ mới vào pipeline một cách tự do. Hóa ra đây chính xác là ý tưởng cho phép các hệ thống batch processing hiện đại kết hợp hàng chục thao tác nhỏ thành một phép tính lớn mà không mảnh nào cần hiểu hết mọi mảnh khác.
MapReduce: cùng ý tưởng đó, trải trên hàng ngàn máy
Một pipeline Unix đơn lẻ chạy trên một máy. MapReduce — framework Google giới thiệu và phổ biến, và sau này Hadoop mang ra ngoài Google — lấy đúng pattern “đọc input, biến đổi nó, gom nhóm nó, ghi output” đó và trải nó ra trên cả một cluster máy, để có thể nhai được những tập dữ liệu quá lớn cho bất kỳ một máy đơn lẻ nào chứa nổi.
Bước map nhận input, được chia trên nhiều máy, và biến đổi từng bản ghi riêng lẻ một cách độc lập — trong ví dụ đếm từ, biến mỗi dòng text thành một chuỗi cặp (từ, 1). Sau đó tới shuffle: mọi cặp có cùng một từ được định tuyến về cùng một máy, để máy đó thấy được mọi lần xuất hiện của đúng từ đó gộp lại với nhau. Cuối cùng bước reduce nhận từng nhóm và gộp nó thành câu trả lời cuối — cộng hết các số 1 của một từ để ra tổng số lần xuất hiện. Input và output ở mỗi giai đoạn đều nằm trên một hệ thống file phân tán (phiên bản của Hadoop gọi là HDFS), đó chính là thứ cho phép toàn bộ việc này mở rộng ra được tới dữ liệu trải trên hàng trăm máy ngay từ đầu.
Chỗ MapReduce thực sự khéo léo: join theo kiểu batch
Ngoài việc đếm đơn giản, chương dành thời gian đáng kể cho một thứ tôi chưa từng nghĩ tới trước đây: làm sao join hai tập dữ liệu khổng lồ — ví dụ, một log hoạt động người dùng và một bảng profile người dùng riêng — khi cả hai đều quá lớn để nằm gọn trên một máy và bạn không thể chỉ chạy một join kiểu database thông thường? Cuốn sách trình bày vài cách tiếp cận, và sự đánh đổi giữa chúng là thứ thực sự đáng để ghi nhớ:
Một sort-merge join sắp xếp cả hai tập dữ liệu theo key chung (ví dụ, user ID) rồi chạy xuyên qua chúng cùng lúc, khớp các bản ghi khi đi tới — về tinh thần khá giống cách sort gom các từ giống nhau lại với nhau trong ví dụ Unix, chỉ là làm ở quy mô lớn hơn nhiều trên cả một cluster. Một broadcast hash join thay vào đó nhận ra rằng một trong hai tập dữ liệu (tập nhỏ hơn, như bảng profile người dùng) có thể nằm gọn hoàn toàn trong bộ nhớ trên mọi máy, nên nó được sao chép ra cho tất cả các máy, và mỗi máy sau đó có thể tự tra cứu khớp cục bộ mà không cần sắp xếp hay shuffle tập dữ liệu khổng lồ kia chút nào. Cái nào tốt hơn phụ thuộc hoàn toàn vào chênh lệch kích thước thực tế giữa hai tập dữ liệu — đúng kiểu bài học “hiểu rõ workload thực tế của mình” từng xuất hiện ở ví dụ timeline Twitter trước đây.
Vì sao sơ đồ này quan trọng: không phải hệ thống batch nào cũng trả cùng một cái giá về đĩa
Quyết định thiết kế định hình nhiều nhất cách batch processing tiến hóa sau MapReduce gốc chính xác là điều sơ đồ ở trên thể hiện. MapReduce cổ điển nối các job lại bằng cách để mỗi job ghi toàn bộ output của nó xuống hệ thống file phân tán trước khi job tiếp theo được phép bắt đầu đọc nó — an toàn và đơn giản, nhưng nghĩa là một phép tính có năm bước tuần tự phải trả giá cho năm lượt đi-về đầy đủ tới đĩa, dù ví dụ Unix pipe trước đó chưa bao giờ cần đụng tới đĩa giữa các lệnh. Các dataflow engine mới hơn — Spark, Flink, Tez — sửa đúng điều này: chúng giữ kết quả trung gian trong bộ nhớ và truyền dữ liệu trực tiếp từ giai đoạn xử lý này sang giai đoạn tiếp theo bất cứ khi nào có thể, chỉ đụng tới đĩa khi thực sự cần (hết bộ nhớ, hoặc ghi kết quả cuối cùng). Đây là một phần lớn lý do vì sao một job Spark làm cùng công việc với một job MapReduce kiểu cũ có thể chạy nhanh hơn đáng kể: không phải nhờ thuật toán thông minh hơn, chỉ đơn giản là ít I/O đĩa không cần thiết hơn nhiều giữa các bước.
Nhìn về phía trước, chương này thực chất là “nửa đầu” của một cặp — batch processing hoạt động tuyệt vời khi bạn sẵn sàng chờ toàn bộ input được gom đủ rồi mới tính toán gì đó (một báo cáo hàng đêm, xử lý lại log của cả một năm). Chương tiếp theo giải quyết trường hợp ngược lại: tạo ra derived data liên tục, khi sự kiện mới tới từng cái một, thay vì chờ gom đủ một mẻ hoàn chỉnh.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.