~/blog/2026
DDIA Chapter 1: Reliable, Scalable, MaintainableDDIA Chương 1: Reliable, Scalable, Maintainable

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 1: Reliable, Scalable, and Maintainable Applications.
Before writing about replication and partitioning, I want to go back to the beginning of the book, because chapter 1 is where Kleppmann defines the three words that everything else in the book keeps circling back to: reliable, scalable, and maintainable. They sound like generic buzzwords you’d see on a job posting, but the book gives each one a precise, useful meaning, and once I had those definitions in my head, I started noticing them everywhere in systems I already use every day.
Reliable: it keeps working even when things go wrong
My first instinct was to define “reliable” as “it doesn’t crash.” The book’s definition is more specific and more useful: a system is reliable if it keeps working correctly, even when something goes wrong — hardware fails, software has bugs, or a human makes a mistake. Note the framing: reliability isn’t about pretending failures won’t happen, it’s about how gracefully the system absorbs them when they inevitably do.
The book splits the causes of failure into three buckets, and I found the everyday analogy for each one pretty intuitive:
- Hardware faults — a hard disk dies, a power supply fails, someone unplugs the wrong cable in a data center. This is like a single delivery truck breaking down. The fix isn’t “build an indestructible truck” (impossible), it’s “have enough trucks and enough redundancy that one breaking down doesn’t stop deliveries.” In practice this means replication and redundant hardware — which is exactly what I wrote about in my Chapter 5 note on replication: if one machine holding your data dies, a copy on another machine keeps serving requests.
- Software errors — a bug that only shows up under a specific, rare combination of inputs, and then hits every server running that code at the same time, because they’re all running the identical buggy version. This is scarier than hardware failure precisely because redundancy doesn’t save you — ten copies of the same buggy program will all fail the same way, at the same moment, given the same trigger.
- Human error — the leading real-world cause of outages, by most accounts. Someone runs the wrong command, misconfigures a server, or pushes a bad deploy. The book’s take, which I really liked, is that the answer isn’t “tell people to be more careful” (that never works at scale), it’s designing systems that make the dangerous action hard to do by accident and easy to undo — good defaults, sandboxes to test changes safely before they touch real data, and fast rollback when something does go wrong.
Scalability: it’s not one number, it’s “can it handle more?”
This is the chapter section I found most immediately useful, because “scalable” is a word I’d been using loosely for years without a precise meaning. The book’s definition: scalability is a system’s ability to cope with increased load — meaning you first have to be able to describe your load precisely (how many requests per second, how many active users, what’s the read/write ratio) before “scalable” means anything concrete at all. “Our system is scalable” is meaningless on its own; “our system can handle 10x the current write volume by adding more machines, without a code rewrite” is an actual, checkable claim.
The book’s running example here is Twitter’s home timeline, and it’s a genuinely great illustration of why “how do I handle more load” doesn’t have one universal answer — it depends entirely on the shape of your specific problem:
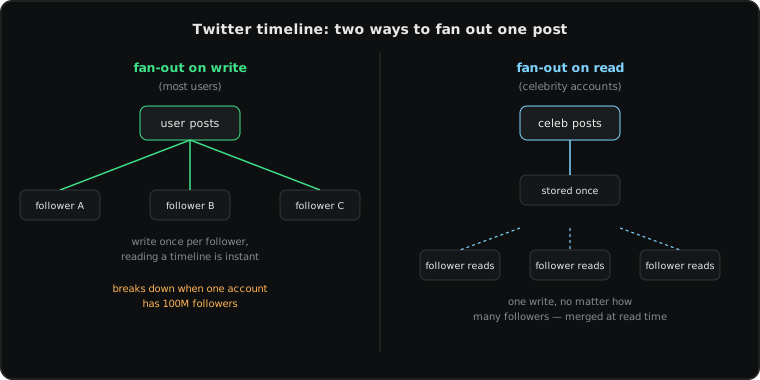
- Fan-out on write: when you post a tweet, the system immediately pushes a copy of it into the precomputed timeline of every one of your followers. Reading your timeline later is then almost instant — it’s already sitting there, ready to serve. This works beautifully for a normal user with a few hundred followers. It falls apart for a celebrity with 100 million followers, because one single post now triggers 100 million writes, all at once.
- Fan-out on read: instead of pre-pushing anything, the system stores the tweet exactly once, and only assembles a follower’s timeline — merging together everyone they follow — at the moment that follower actually opens the app and asks for it. This avoids the celebrity-post write storm entirely, at the cost of making every single read more expensive, since it has to gather and merge data live instead of just handing over something already prepared.
What Twitter actually does, per the book, is a hybrid: fan-out on write for ordinary accounts (cheap writes, fast reads, and this covers the vast majority of posts), and fan-out on read specifically for the small number of accounts with an enormous follower count (accepting slower reads for those specific posts, to avoid the write storm). I found this a really satisfying example of a broader lesson: scalability solutions are rarely “pick the universally correct algorithm” — they’re “understand your actual traffic pattern well enough to apply the cheap trick to the common case, and pay the expensive cost only where it’s unavoidable.”
The book also spends real time on describing performance precisely, and this is where “percentiles” clicked for me in a way “average latency” never did. If you only look at average response time, one very slow outlier request can hide in plain sight, averaged away by thousands of fast ones. What actually matters to users is the tail: the p95 (95th percentile — the response time that 95% of requests are faster than) or p99. A system with a great average but a bad p99 means 1% of your users — which, at real scale, might be tens of thousands of people — are having a genuinely bad time, every single day, invisible in your average-latency dashboard.
Maintainability: most of a system’s cost is after it ships
The last third of the chapter is about something that isn’t glamorous but is, in the book’s own words, where most of the money actually goes: maintainability — how easy the system is to operate, understand, and change after it’s already live, which the book breaks into three sub-qualities:
- Operability — making it easy for the people running the system day-to-day to keep it healthy: good monitoring, predictable behavior, clear documentation for what to do when something breaks at 3 a.m.
- Simplicity — managing the complexity of the system so that new engineers can actually understand it, as opposed to it becoming what the book memorably calls a “big ball of mud” that only the one person who wrote it three years ago fully understands (and who has since left the company).
- Evolvability — how easy it is to change the system later as requirements inevitably shift, because the one thing you can be certain of about any real system’s requirements is that they will change.
The honest reason this chapter matters as an opener: almost every concrete technical decision covered later in the book — replication, partitioning, which storage engine to pick, which consistency guarantee to promise — is really just a specific answer to one of these three questions in disguise. Reading chapter 1 first gives you the vocabulary to actually explain why a later design choice is good, instead of just recognizing that it is.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 1: Reliable, Scalable, and Maintainable Applications.
Trước khi viết về replication và partitioning, tôi muốn quay lại phần mở đầu cuốn sách, vì chương 1 là nơi Kleppmann định nghĩa ba từ mà cả cuốn sách cứ xoay quanh mãi: reliable (đáng tin cậy), scalable (mở rộng được), và maintainable (dễ bảo trì). Nghe qua thì giống mấy từ chung chung hay thấy trong tin tuyển dụng, nhưng cuốn sách cho mỗi từ một định nghĩa chính xác, hữu ích, và một khi đã nắm được định nghĩa đó, tôi bắt đầu thấy chúng xuất hiện khắp nơi trong những hệ thống mình dùng hằng ngày.
Reliable: vẫn chạy đúng ngay cả khi có sự cố
Bản năng đầu tiên của tôi là định nghĩa “reliable” là “không bị crash.” Định nghĩa trong sách cụ thể và hữu ích hơn nhiều: một hệ thống được coi là reliable nếu nó vẫn tiếp tục hoạt động đúng, ngay cả khi có gì đó trục trặc — phần cứng hỏng, phần mềm có bug, hoặc con người mắc sai lầm. Chú ý cách đóng khung vấn đề: reliability không phải là giả vờ sự cố sẽ không xảy ra, mà là hệ thống hấp thụ sự cố đó một cách nhẹ nhàng ra sao khi nó chắc chắn sẽ xảy ra.
Cuốn sách chia nguyên nhân gây sự cố thành ba nhóm, và tôi thấy ví dụ đời thường cho từng nhóm khá dễ hình dung:
- Hardware faults (lỗi phần cứng) — ổ cứng hỏng, nguồn điện chết, có người rút nhầm dây cáp trong trung tâm dữ liệu. Giống như một chiếc xe tải giao hàng bị hỏng giữa đường. Giải pháp không phải “chế tạo một chiếc xe tải không thể hỏng” (bất khả thi), mà là “có đủ xe tải và đủ dự phòng để một chiếc hỏng không làm dừng cả việc giao hàng.” Trong thực tế, điều này nghĩa là replication và phần cứng dự phòng — đúng như những gì tôi đã viết trong bài note về replication ở Chương 5: nếu một máy đang giữ dữ liệu của bạn chết, một bản sao trên máy khác vẫn tiếp tục phục vụ request.
- Software errors (lỗi phần mềm) — một con bug chỉ xuất hiện với một tổ hợp input hiếm gặp cụ thể nào đó, rồi đánh vào mọi server đang chạy đoạn code đó cùng một lúc, vì tất cả đều chạy đúng phiên bản có bug giống hệt nhau. Cái này đáng sợ hơn lỗi phần cứng chính vì redundancy (dự phòng) không cứu được bạn — mười bản sao của cùng một chương trình có bug sẽ đều fail theo cùng một cách, cùng một thời điểm, khi gặp đúng điều kiện kích hoạt đó.
- Human error (lỗi con người) — theo hầu hết thống kê thực tế, đây là nguyên nhân hàng đầu gây ra sự cố ngoài đời. Ai đó chạy nhầm lệnh, cấu hình sai server, hoặc đẩy một bản deploy lỗi. Quan điểm của cuốn sách mà tôi rất thích: câu trả lời không phải là “bảo mọi người cẩn thận hơn” (điều này không bao giờ hiệu quả ở quy mô lớn), mà là thiết kế hệ thống sao cho hành động nguy hiểm khó vô tình xảy ra, và dễ hoàn tác nếu lỡ xảy ra — cấu hình mặc định an toàn, môi trường sandbox để thử thay đổi trước khi đụng vào dữ liệu thật, và khả năng rollback nhanh khi có sự cố.
Scalability: không phải một con số, mà là “có chịu được nhiều hơn không?”
Đây là phần tôi thấy hữu ích ngay lập tức, vì “scalable” là từ tôi vẫn dùng khá tùy tiện bao năm nay mà chưa có định nghĩa chính xác. Định nghĩa trong sách: scalability là khả năng của hệ thống ứng phó với tải tăng lên — nghĩa là trước tiên bạn phải mô tả được tải của mình một cách chính xác (bao nhiêu request mỗi giây, bao nhiêu người dùng đang hoạt động, tỷ lệ đọc/ghi ra sao) thì từ “scalable” mới thực sự có ý nghĩa cụ thể. “Hệ thống của chúng tôi scalable” tự nó chẳng có nghĩa gì; “hệ thống của chúng tôi có thể chịu gấp 10 lần lượng ghi hiện tại chỉ bằng cách thêm máy, không cần viết lại code” mới là một tuyên bố thật sự, kiểm chứng được.
Ví dụ xuyên suốt phần này trong sách là timeline trang chủ của Twitter, và đây thực sự là một minh họa tuyệt vời cho việc “làm sao xử lý nhiều tải hơn” không có một câu trả lời chung cho mọi trường hợp — nó phụ thuộc hoàn toàn vào hình dạng cụ thể của bài toán bạn đang giải:
- Fan-out on write (đẩy dữ liệu ngay khi ghi): khi bạn đăng một tweet, hệ thống lập tức đẩy một bản sao của nó vào timeline đã được tính sẵn của từng follower. Đọc timeline sau đó gần như tức thì — dữ liệu đã nằm sẵn ở đó, chỉ việc lấy ra phục vụ. Cách này hoạt động rất tốt với người dùng bình thường có vài trăm follower. Nhưng nó sụp đổ với một celebrity có 100 triệu follower, vì một bài đăng duy nhất giờ kích hoạt 100 triệu lượt ghi cùng lúc.
- Fan-out on read (ráp dữ liệu ngay khi đọc): thay vì đẩy dữ liệu trước, hệ thống chỉ lưu tweet đúng một lần, và chỉ ráp timeline của một follower — gộp bài từ tất cả những người họ theo dõi — vào đúng khoảnh khắc follower đó mở app và yêu cầu xem. Cách này tránh hoàn toàn cơn bão ghi dữ liệu khi celebrity đăng bài, đổi lại là mỗi lượt đọc giờ tốn kém hơn nhiều, vì phải gom và gộp dữ liệu ngay lúc đó thay vì chỉ đưa ra thứ đã chuẩn bị sẵn.
Điều Twitter thực sự làm, theo sách, là kết hợp cả hai: fan-out on write cho tài khoản bình thường (ghi rẻ, đọc nhanh, và đây là đa số các bài đăng), và fan-out on read riêng cho số ít tài khoản có lượng follower khổng lồ (chấp nhận đọc chậm hơn cho riêng những bài đó, để tránh cơn bão ghi dữ liệu). Tôi thấy đây là một ví dụ rất thỏa mãn cho một bài học rộng hơn: giải pháp scalability hiếm khi là “chọn đúng một thuật toán tối ưu tuyệt đối” — nó là “hiểu đủ rõ pattern traffic thực tế của mình để áp dụng mẹo rẻ cho trường hợp phổ biến, và chỉ trả cái giá đắt ở nơi thực sự không tránh được.”
Cuốn sách cũng dành thời gian đáng kể để mô tả performance một cách chính xác, và đây là chỗ khái niệm “percentile” thực sự “sáng” ra với tôi theo cách mà “average latency” (độ trễ trung bình) chưa bao giờ làm được. Nếu bạn chỉ nhìn vào thời gian phản hồi trung bình, một request cực chậm hiếm gặp có thể trốn kỹ, bị hàng ngàn request nhanh làm loãng đi trong phép tính trung bình. Cái thực sự quan trọng với người dùng là phần đuôi: p95 (percentile thứ 95 — thời gian phản hồi mà 95% request nhanh hơn) hoặc p99. Một hệ thống có average tuyệt vời nhưng p99 tệ nghĩa là 1% người dùng — mà ở quy mô thật, có thể là hàng chục ngàn người — đang có trải nghiệm thực sự tệ, mỗi ngày, mà hoàn toàn vô hình trên dashboard average-latency của bạn.
Maintainability: phần lớn chi phí của hệ thống nằm ở sau khi nó đã ra mắt
Một phần ba cuối chương nói về thứ không hào nhoáng nhưng, theo chính lời cuốn sách, lại là nơi phần lớn tiền bạc thực sự đổ vào: maintainability (khả năng bảo trì) — hệ thống dễ vận hành, dễ hiểu, và dễ thay đổi ra sao sau khi nó đã chạy thật, được sách chia thành ba khía cạnh nhỏ:
- Operability (khả năng vận hành) — giúp những người vận hành hệ thống hằng ngày dễ dàng giữ nó khỏe mạnh: monitoring tốt, hành vi có thể dự đoán được, tài liệu rõ ràng về việc cần làm khi có sự cố lúc 3 giờ sáng.
- Simplicity (tính đơn giản) — quản lý độ phức tạp của hệ thống sao cho kỹ sư mới thực sự hiểu được nó, thay vì để nó trở thành thứ mà sách gọi rất hình tượng là một “cục bùn khổng lồ” mà chỉ một người duy nhất viết ra ba năm trước mới hiểu trọn vẹn (và người đó giờ đã nghỉ việc).
- Evolvability (khả năng tiến hóa) — hệ thống dễ thay đổi ra sao sau này khi yêu cầu chắc chắn sẽ thay đổi, vì điều duy nhất bạn có thể chắc chắn về yêu cầu của bất kỳ hệ thống thật nào là chúng sẽ thay đổi.
Lý do thành thật vì sao chương này quan trọng khi mở đầu cuốn sách: gần như mọi quyết định kỹ thuật cụ thể được nói tới sau này trong sách — replication, partitioning, chọn storage engine nào, hứa hẹn consistency guarantee gì — thực chất chỉ là một câu trả lời cụ thể, trá hình, cho một trong ba câu hỏi này. Đọc chương 1 trước giúp bạn có sẵn từ vựng để thực sự giải thích vì sao một quyết định thiết kế sau này là tốt, thay vì chỉ nhận ra rằng nó tốt.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.