~/blog/2026
DDIA Chapter 6: PartitioningDDIA Chương 6: Partitioning

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 6: Partitioning.
Chapter 5 was about replication — keeping copies of the same data on multiple machines so the system survives one of them dying. This chapter is about something that sounds similar but is actually a completely separate problem: what do you do when your data is simply too big, or gets too much traffic, for any single machine to handle at all, even a perfectly healthy one? The answer is partitioning (also called sharding): splitting your data into smaller pieces and spreading those pieces across many machines.
It’s worth sitting with why these are different problems before going further, because I originally assumed “replication” and “partitioning” were basically the same idea. They’re not. Replication answers “what if this machine dies?” Partitioning answers “what if this machine simply can’t fit or serve all the data by itself, dead or alive?” In a real system you almost always need both at once: split the data into partitions to spread the load, and replicate each partition so any one machine holding a piece of it can still die without losing data. Chapter 5 was about the replication half. This chapter is about the splitting half.
The core decision: how do you decide what goes where?
Say you have a huge table of user data and ten machines to spread it across. The obvious first idea is “put user A’s data on machine 1, user B’s on machine 2,” and so on. But how do you decide, systematically, which machine any given piece of data belongs on? DDIA covers two main strategies, and the tradeoff between them is the whole chapter in miniature.
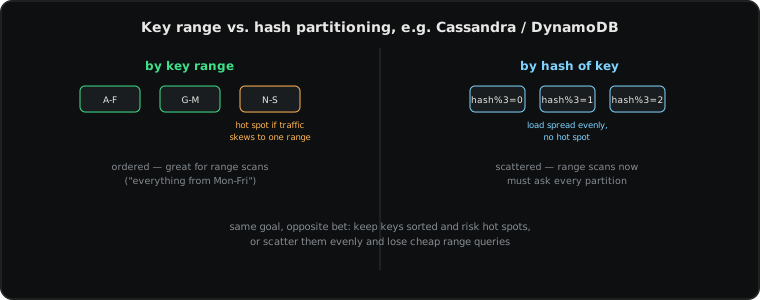
Partitioning by key range is like splitting a printed encyclopedia into volumes: Volume 1 covers entries A through D, Volume 2 covers E through H, and so on. Any entry has an obvious, predictable home based on where it falls alphabetically. The nice side effect: if you want to look up everything between “Da” and “De,” you know exactly which single volume to grab, and you can even scan through it in sorted order efficiently. The problem: if your encyclopedia happens to be about celebrities, and suddenly everyone is looking up entries starting with “S” this week for some reason, the poor volume covering “S” gets hammered with traffic while every other volume sits idle. This uneven load is called a hot spot, and it’s the classic weakness of range-based partitioning. A very real-world version of this: if you partition by timestamp (because timestamps happen to sort nicely), all new data being written right now lands on whichever single partition owns “today,” no matter how many machines you have.
Partitioning by hash of the key fixes the hot-spot problem by deliberately throwing away the nice ordering. Instead of “wherever this key alphabetically belongs,” you run the key through a hash function (a formula that turns any input into a number that looks essentially random and evenly spread out) and use that number to pick a machine. Now the data is scattered evenly and unpredictably across all your machines, so no single machine gets stuck holding “today’s” data or “everything starting with S.” The tradeoff: you’ve lost the ability to efficiently ask for a range of keys (like “everything from Monday to Friday”), because a range of real keys no longer corresponds to a nearby range of hash values — they’re scattered randomly across every machine, so a range query now has to ask every single machine instead of just one.
Neither approach is “better” in general — it genuinely depends on whether your application needs efficient range queries more than it needs even load distribution, and that’s a real design decision, not something a database can automatically get right for you.
The celebrity problem
Even hash partitioning, which is supposed to spread load evenly, can still get ambushed by a single extremely popular piece of data — DDIA calls this a skewed workload. Imagine a social media platform where load is partitioned by user ID, which is normally a perfectly reasonable, evenly-distributed choice. Then a celebrity with a hundred million followers posts something, and suddenly one single user ID (the celebrity’s) is generating a wildly disproportionate amount of read and write traffic compared to literally every other user in the system — hashing didn’t help, because the problem was never that user IDs were unevenly spread out, it’s that a small number of specific keys are just genuinely, unavoidably way “hotter” than the rest. One practical trick the book mentions: for a small number of known hot keys, you can append a random suffix (splitting the celebrity’s data across, say, 20 sub-keys instead of one) purely to spread that one key’s load across multiple machines — at the cost of now having to gather and combine results from all 20 sub-keys whenever you need “the real” data for that key.
Searching by something other than the partition key gets messy
Partitioning works cleanly as long as you’re always looking things up by the exact key you partitioned on. Real applications also want to search by other attributes — “find all cars that are red,” when your data is partitioned by car ID, not by color. This is where secondary indexes (an index on a column other than the main key) run into trouble, and DDIA describes two approaches, each with a real cost:
- Local indexes (partitioned by document): each machine keeps an index covering only the data that already physically lives on it — like each branch library keeping an index of only the books in that specific building. Writing new data is simple (you only ever touch the one machine that owns it), but a search like “find all red cars” now has to ask every single machine to check its own local index and then combine all the answers together — a pattern called scatter/gather. It works, but it’s slow and its cost grows with the number of machines you have.
- Global indexes (partitioned by term): instead, you maintain one shared index — say, split up by color instead of by car ID — covering the entire dataset regardless of which machine each car physically lives on. Now “find all red cars” is fast, because you only have to check the one part of the index that covers “red.” The cost shows up on the write side instead: adding one new car might now require updating an index partition that lives on a completely different machine from where the car’s own data lives, and keeping that update honest and consistent across machines is genuinely harder to get right.
I found this a really clean example of a pattern that shows up everywhere in system design: you can’t make both reads and writes maximally cheap and simple at the same time — you’re choosing which side absorbs the complexity, based on which one your application actually does more of.
Rebalancing without a truck full of movers
Systems grow. You’ll eventually add more machines, and existing data has to get reshuffled across the new, larger set of machines — this is called rebalancing. The naive approach — literally computing hash(key) mod number_of_machines to decide where something lives — sounds reasonable until you realize that adding just one extra machine changes the divisor, which changes the answer for almost every single key in the entire database simultaneously. That’s the data equivalent of renumbering every house on every street in a city just because one new street got added — a genuinely enormous, unnecessary amount of data movement for a small change in capacity.
Real systems avoid this in one of a couple of ways:
- Start with far more partitions than you currently have machines — say, always keep exactly 1,000 fixed partitions in existence, even on day one with just a handful of machines. Growing the cluster then just means moving some of those already-existing partitions onto the new machines, rather than recomputing where every single piece of data belongs from scratch.
- Split partitions dynamically as they grow, the way a very popular Wikipedia article’s edit history might eventually get split into “part 1” and “part 2” once it gets unmanageably long — a partition that grows past a size threshold gets automatically split in two, and one of the two halves can then be handed off to a different, less busy machine.
Either way, the goal is the same: change where a chunk of data lives without needing to change how the data is chunked in the first place every time the cluster’s size changes even slightly.
How does a client even know which machine to ask?
If data is scattered across dozens of machines and can be reshuffled at any time as the cluster grows, a client application obviously can’t just hardcode “user data lives on machine 7.” Something in the system has to track, in real time, the current answer to “which machine currently owns this piece of data,” and make that answer available to whoever’s asking. DDIA describes a few shapes this can take — a client might ask any machine and get redirected to the right one, or there might be a dedicated routing layer in front of everything, or the client itself might keep track directly — but in practice, most real systems solve this by leaning on a separate, small, extremely reliable coordination service (ZooKeeper is the most commonly cited example) that acts like a shared, trusted bulletin board: every machine posts “here’s what I currently own” to this bulletin board, and anyone who needs to route a request — the client, a routing tier, or another machine — just checks the board instead of needing to independently track every change themselves.
Tying this back to Chapter 5
The thing I keep coming back to after finishing this chapter: replication and partitioning solve genuinely different problems, but almost no real system uses just one of them. You partition to spread out load and size across many machines, and you replicate each partition so that any one of those machines dying doesn’t cost you the data it was holding. Chapter 5 explained how to keep multiple copies of one dataset in sync. This chapter explained how to split one enormous dataset into pieces small enough for a single machine to reasonably own in the first place. Put together, that’s most of what “distributed database” actually means in practice — everything else is refinements on top of these two decisions.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 6: Partitioning.
Chương 5 nói về replication — giữ nhiều bản sao của cùng dữ liệu trên nhiều máy để hệ thống sống sót khi một máy chết. Chương này nghe có vẻ tương tự nhưng thực ra là một vấn đề hoàn toàn khác: bạn làm gì khi dữ liệu của mình đơn giản là quá lớn, hoặc nhận quá nhiều traffic, đến mức bất kỳ một máy đơn lẻ nào cũng không thể xử lý nổi, kể cả khi máy đó hoàn toàn khỏe mạnh? Câu trả lời là partitioning (còn gọi là sharding): chia dữ liệu thành nhiều mảnh nhỏ hơn và trải chúng ra trên nhiều máy.
Đáng để dừng lại suy nghĩ vì sao hai thứ này khác nhau trước khi đi tiếp, vì ban đầu tôi cứ nghĩ “replication” và “partitioning” về cơ bản là một ý tưởng. Không phải vậy. Replication trả lời câu hỏi “nếu máy này chết thì sao?” Partitioning trả lời câu hỏi “nếu máy này đơn giản là không thể chứa hoặc phục vụ nổi toàn bộ dữ liệu, dù sống hay chết, thì sao?” Trong một hệ thống thật, bạn hầu như luôn cần cả hai cùng lúc: chia dữ liệu thành các partition để trải tải ra, và replicate từng partition để bất kỳ máy nào đang giữ một mảnh trong đó chết đi cũng không làm mất dữ liệu. Chương 5 nói về nửa replication. Chương này nói về nửa chia nhỏ.
Quyết định cốt lõi: làm sao biết cái gì thuộc về đâu?
Giả sử bạn có một bảng dữ liệu người dùng khổng lồ và mười máy để trải nó ra. Ý tưởng đầu tiên hiển nhiên là “để dữ liệu người dùng A trên máy 1, người dùng B trên máy 2,” cứ thế. Nhưng bạn quyết định như thế nào, một cách có hệ thống, xem một mẩu dữ liệu bất kỳ thuộc về máy nào? DDIA trình bày hai chiến lược chính, và sự đánh đổi giữa chúng chính là cả chương này thu nhỏ lại.
Partitioning theo dải key (key range) giống như chia một bộ bách khoa toàn thư in giấy thành các tập: Tập 1 gồm các mục từ A đến D, Tập 2 từ E đến H, cứ thế. Bất kỳ mục từ nào cũng có một “nhà” rõ ràng, dự đoán được, dựa theo vị trí của nó trong bảng chữ cái. Hiệu ứng phụ hay ho: nếu bạn muốn tra mọi thứ từ “Da” đến “De,” bạn biết chính xác cần lấy đúng một tập nào, và thậm chí có thể lướt qua nó theo thứ tự đã sắp xếp một cách hiệu quả. Vấn đề: nếu bộ bách khoa toàn thư của bạn tình cờ là về người nổi tiếng, và tuần này vì lý do gì đó mọi người đều tra các mục bắt đầu bằng chữ “S,” thì tội nghiệp cái tập phủ chữ “S” bị dội bom traffic trong khi mọi tập khác nằm không. Tải không đồng đều này gọi là hot spot, và đó là điểm yếu kinh điển của partitioning theo dải. Một phiên bản rất thực tế của điều này: nếu bạn partition theo timestamp (vì timestamp tình cờ sắp xếp rất gọn gàng), toàn bộ dữ liệu mới đang được ghi ngay lúc này sẽ dồn vào đúng một partition đang sở hữu “hôm nay,” bất kể bạn có bao nhiêu máy đi nữa.
Partitioning theo hash của key giải quyết vấn đề hot spot bằng cách cố tình vứt bỏ luôn cái thứ tự gọn gàng đó. Thay vì “thuộc về đâu theo bảng chữ cái,” bạn chạy key qua một hàm hash (một công thức biến bất kỳ đầu vào nào thành một con số trông gần như ngẫu nhiên và trải đều) rồi dùng con số đó để chọn máy. Giờ dữ liệu được rải đều và không thể đoán trước trên tất cả các máy, nên không máy nào bị kẹt phải giữ “dữ liệu hôm nay” hay “mọi thứ bắt đầu bằng S.” Đánh đổi: bạn mất khả năng hỏi hiệu quả về một dải key (kiểu “mọi thứ từ thứ Hai đến thứ Sáu”), vì một dải key thật không còn tương ứng với một dải giá trị hash gần nhau nữa — chúng bị rải ngẫu nhiên trên mọi máy, nên giờ một truy vấn theo dải phải hỏi từng máy một thay vì chỉ một máy.
Không cách nào “tốt hơn” nói chung — nó thực sự phụ thuộc vào việc ứng dụng của bạn cần truy vấn theo dải hiệu quả hơn hay cần tải phân bố đều hơn, và đó là một quyết định thiết kế thật sự, không phải thứ database có thể tự động làm đúng thay bạn.
Vấn đề “người nổi tiếng”
Ngay cả hash partitioning, thứ vốn được kỳ vọng trải tải đều, vẫn có thể bị phục kích bởi đúng một mẩu dữ liệu cực kỳ nổi tiếng — DDIA gọi đây là skewed workload (tải lệch). Tưởng tượng một nền tảng mạng xã hội mà tải được partition theo user ID, vốn dĩ là một lựa chọn hoàn toàn hợp lý, phân bố đều. Rồi một người nổi tiếng với hàng trăm triệu follower đăng một bài, và đột nhiên đúng một user ID (của người nổi tiếng đó) tạo ra một lượng traffic đọc/ghi lệch hẳn so với mọi người dùng khác trong hệ thống — hashing không giúp được gì, vì vấn đề chưa bao giờ là user ID phân bố không đều, mà là một số ít key cụ thể đơn giản là “nóng” hơn hẳn phần còn lại một cách không thể tránh khỏi. Một mẹo thực tế cuốn sách nhắc tới: với một số ít key nóng đã biết trước, bạn có thể gắn thêm một hậu tố ngẫu nhiên (chia dữ liệu của người nổi tiếng ra thành, ví dụ, 20 sub-key thay vì một) chỉ để trải tải của đúng key đó ra nhiều máy — đổi lại là giờ bạn phải gom và kết hợp kết quả từ cả 20 sub-key mỗi khi cần “dữ liệu thật” của key đó.
Tìm kiếm theo thứ khác ngoài partition key thì rắc rối
Partitioning hoạt động gọn gàng miễn là bạn luôn tra cứu bằng đúng key mình đã dùng để partition. Ứng dụng thực tế cũng muốn tìm theo thuộc tính khác — “tìm mọi xe màu đỏ,” trong khi dữ liệu của bạn được partition theo ID xe, không phải theo màu. Đây là chỗ secondary index (index trên một cột khác ngoài key chính) gặp rắc rối, và DDIA mô tả hai cách tiếp cận, mỗi cách đều có cái giá thật:
- Local index (partition theo document): mỗi máy giữ một index chỉ phủ dữ liệu đã nằm sẵn trên chính nó — giống như mỗi chi nhánh thư viện chỉ giữ index của những cuốn sách trong đúng tòa nhà đó. Ghi dữ liệu mới thì đơn giản (bạn chỉ đụng đúng một máy sở hữu nó), nhưng một truy vấn kiểu “tìm mọi xe đỏ” giờ phải hỏi từng máy một để kiểm tra index cục bộ của nó rồi gộp mọi câu trả lời lại — một pattern gọi là scatter/gather. Nó hoạt động, nhưng chậm và chi phí tăng theo số máy bạn có.
- Global index (partition theo term): thay vào đó, bạn duy trì một index dùng chung — ví dụ, chia theo màu thay vì theo ID xe — phủ toàn bộ dữ liệu bất kể mỗi xe thực sự nằm trên máy nào. Giờ “tìm mọi xe đỏ” nhanh, vì bạn chỉ cần kiểm tra đúng phần index phủ “đỏ.” Cái giá lộ ra ở phía ghi thay vào đó: thêm một xe mới giờ có thể cần cập nhật một partition index nằm trên một máy hoàn toàn khác với máy chứa dữ liệu của chính chiếc xe đó, và giữ cho cập nhật đó trung thực, nhất quán qua nhiều máy thực sự khó làm đúng hơn.
Tôi thấy đây là một ví dụ rất gọn gàng cho một pattern xuất hiện khắp nơi trong thiết kế hệ thống: bạn không thể làm cho cả đọc lẫn ghi đều rẻ và đơn giản tối đa cùng lúc — bạn đang chọn bên nào hấp thụ sự phức tạp, dựa trên việc ứng dụng của bạn thực sự làm nhiều thao tác nào hơn.
Cân bằng lại mà không cần cả xe tải chở đồ
Hệ thống rồi sẽ lớn lên. Bạn sẽ thêm máy mới vào lúc nào đó, và dữ liệu hiện có phải được xáo trộn lại trên tập máy mới, lớn hơn — gọi là rebalancing. Cách tiếp cận ngây thơ — tính thẳng hash(key) mod số_lượng_máy để quyết định dữ liệu nằm ở đâu — nghe có vẻ hợp lý cho đến khi bạn nhận ra chỉ cần thêm một máy thôi cũng đổi số chia, làm đổi luôn câu trả lời cho gần như mọi key trong toàn bộ database cùng lúc. Đó là phiên bản dữ liệu của việc đánh số lại mọi căn nhà trên mọi con phố trong thành phố chỉ vì có thêm một con phố mới — một lượng di chuyển dữ liệu khổng lồ, không cần thiết cho một thay đổi nhỏ về công suất.
Hệ thống thật tránh điều này theo một trong vài cách:
- Bắt đầu với số partition nhiều hơn hẳn số máy hiện có — ví dụ, luôn giữ đúng 1.000 partition cố định ngay từ ngày đầu, kể cả khi chỉ có vài máy. Mở rộng cluster khi đó chỉ đơn giản là chuyển một số partition đã tồn tại sẵn sang máy mới, thay vì tính lại từ đầu xem mỗi mẩu dữ liệu thuộc về đâu.
- Tự động chia nhỏ partition khi chúng lớn lên, giống như lịch sử chỉnh sửa của một bài Wikipedia cực kỳ nổi tiếng cuối cùng có thể được chia thành “phần 1” và “phần 2” khi nó dài đến mức khó quản lý — một partition vượt quá một ngưỡng kích thước sẽ tự động bị chia đôi, và một trong hai nửa có thể được giao cho một máy khác, ít bận hơn.
Dù theo cách nào, mục tiêu vẫn vậy: đổi nơi một mẩu dữ liệu đang nằm mà không cần đổi cách dữ liệu được chia nhỏ ngay từ đầu mỗi khi kích thước cluster thay đổi dù chỉ một chút.
Vậy client làm sao biết phải hỏi máy nào?
Nếu dữ liệu được rải trên hàng chục máy và có thể bị xáo trộn lại bất cứ lúc nào khi cluster lớn lên, một ứng dụng client rõ ràng không thể chỉ hardcode “dữ liệu người dùng nằm trên máy 7.” Phải có thứ gì đó trong hệ thống theo dõi, theo thời gian thực, câu trả lời hiện tại cho câu hỏi “mẩu dữ liệu này hiện đang thuộc về máy nào,” và cung cấp câu trả lời đó cho bất kỳ ai đang hỏi. DDIA mô tả vài hình dạng khác nhau cho việc này — client có thể hỏi bất kỳ máy nào rồi được chuyển hướng tới đúng máy, hoặc có thể có một tầng định tuyến riêng đứng trước mọi thứ, hoặc chính client có thể tự theo dõi trực tiếp — nhưng trong thực tế, hầu hết hệ thống thật giải quyết việc này bằng cách dựa vào một coordination service (dịch vụ điều phối) riêng, nhỏ, cực kỳ đáng tin cậy (ZooKeeper là ví dụ hay được nhắc tới nhất) hoạt động như một bảng thông báo chung, đáng tin: mỗi máy dán “đây là những gì tôi đang sở hữu” lên bảng thông báo này, và bất kỳ ai cần định tuyến một request — client, một tầng định tuyến, hay một máy khác — chỉ cần nhìn vào bảng thay vì phải tự theo dõi độc lập từng thay đổi.
Nối lại với Chương 5
Điều tôi cứ nghĩ lại sau khi đọc xong chương này: replication và partitioning giải quyết những vấn đề thực sự khác nhau, nhưng gần như không hệ thống thật nào chỉ dùng một trong hai. Bạn partition để trải tải và kích thước ra nhiều máy, và bạn replicate từng partition để bất kỳ máy nào trong số đó chết đi cũng không làm mất dữ liệu nó đang giữ. Chương 5 giải thích cách giữ nhiều bản sao của một tập dữ liệu đồng bộ với nhau. Chương này giải thích cách chia một tập dữ liệu khổng lồ thành các mảnh đủ nhỏ để một máy đơn lẻ có thể sở hữu một cách hợp lý ngay từ đầu. Gộp lại, đó là phần lớn ý nghĩa thực sự của “distributed database” trong thực tế — mọi thứ còn lại chỉ là tinh chỉnh thêm trên hai quyết định này.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.