~/blog/2026
DDIA Chapter 3: Storage and RetrievalDDIA Chương 3: Storage and Retrieval

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 3: Storage and Retrieval.
After data models, the book goes one level deeper: forget how your data looks to your application for a moment — how does the database actually store it on an actual physical disk, in a way that lets it find any given piece of it back quickly? This is the chapter where I finally understood why Postgres and Cassandra genuinely behave like different animals under load, instead of just “both being databases.”
The simplest possible database, and why it’s bad
The book opens with a deliberately silly toy database: a script that appends every write as a new line to a text file, and looks things up by scanning the entire file from the top every single time. Writes are blazing fast (just append a line — nothing to search for, nothing to reorganize). Reads are painfully slow once the file gets big, because every single lookup means scanning potentially millions of lines. This toy example matters because it sets up the entire chapter’s central tension: fast writes and fast reads pull the storage engine’s design in opposite directions, and every real storage engine is really just a specific, clever compromise between the two.
The first real improvement the book introduces is an index — a separate, smaller structure that tells you exactly where to look, so reads don’t need a full scan. But an index isn’t free: every index you add makes writes slightly slower, because now every write has to update the index too, not just append the raw data. This is a genuinely useful mental model I didn’t have before: every index is a bet that you’ll read that field often enough to be worth paying a small write-cost on every single write, forever.
The two families: B-trees and LSM-trees
The chapter’s real payoff is a head-to-head comparison of the two dominant storage engine designs used in real production databases today, and once I saw them side by side, a lot of “why does this database behave this way” questions I’d had for years just resolved themselves:
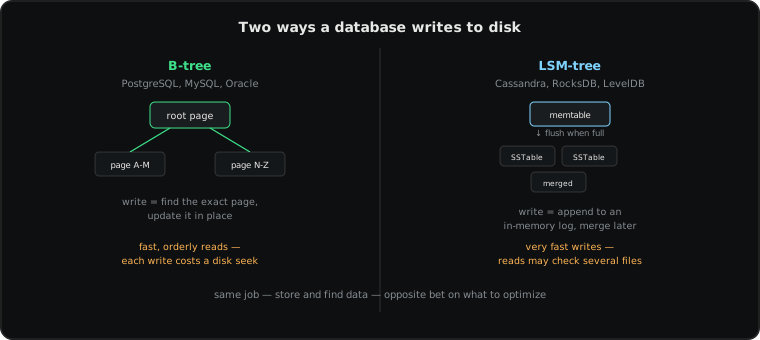
B-trees — used by PostgreSQL, MySQL/InnoDB, and Oracle, among many others — organize data on disk into fixed-size pages arranged in a tree, where each write finds the exact page a key belongs to and updates it directly in place. This is the same basic idea as an old-school library card catalog: everything is kept in strict, browsable order, so both “find this one book” and “find every book between these two call numbers” are fast and predictable. The cost is that every single write means finding a specific spot on the physical disk and modifying it there, which — especially on spinning disks, and even on SSDs to a lesser degree — is a comparatively expensive operation called a seek, and it happens on every write.
LSM-trees (log-structured merge-trees) — used by Cassandra, RocksDB, LevelDB, and HBase — take the toy append-only log idea from the start of the chapter and make it genuinely production-grade. New writes first land in a small, fast, in-memory structure (a memtable). Once that fills up, it gets flushed to disk as an immutable file (an SSTable), and a background process periodically merges older SSTables together, discarding overwritten or deleted values along the way — a process called compaction. Because writes never modify anything in place — they only ever append — write throughput can be dramatically higher than a B-tree’s. The cost shows up on reads: a single lookup might, in the worst case, have to check the memtable and several SSTables before it finds the answer (or confirms it doesn’t exist), though clever tricks like Bloom filters — a small, probabilistic structure that can quickly say “this key is definitely not in this file” without actually reading the file — claw a lot of that read cost back.
The everyday analogy that stuck with me: a B-tree is like keeping one perfectly alphabetized filing cabinet, where every new document gets carefully inserted into its exact correct spot right away — precise, but slow to file each new piece of paper. An LSM-tree is like tossing every new document onto an always-growing “inbox” pile, and only periodically, in the background, sorting and merging those piles into neater ones — fast to receive new paper, but you might have to check a few piles before you’re sure you’ve found (or ruled out) a given document.
Neither is “better” — it comes back to the same tension from the very start of the chapter. Workloads that write constantly and read less often (logging systems, time-series data, write-heavy analytics pipelines) tend to love LSM-trees. Workloads that need consistently fast, predictable reads and can tolerate somewhat slower writes tend to reach for B-trees. This is exactly why Cassandra (LSM-tree) is the go-to choice for something like storing a constant stream of IoT sensor data, while Postgres (B-tree) is the go-to choice for a banking system’s account balances, where you’re reading a specific account far more often than you’re bulk-writing.
OLTP vs OLAP: two completely different jobs wearing the same word, “database”
The last part of the chapter draws a line I’d always sort of sensed but never had clean vocabulary for: OLTP (online transaction processing) versus OLAP (online analytic processing). They’re both “databases,” but they’re optimized for almost opposite access patterns:
- OLTP is what runs your actual application in real time — a user checking their bank balance, an app adding an item to a cart. Each query touches a small number of rows, but there are a huge number of concurrent queries happening every second, from many different users, each looking at their own tiny slice of the data.
- OLAP is what a business analyst runs at the end of the quarter to answer something like “what was our total revenue by region, across the last two years?” Each query might scan millions of rows, but there are relatively few such queries, usually run by internal analysts rather than end users in real time.
This split explains a design choice I’d seen without understanding why: column-oriented storage, used by systems like ClickHouse (which I wrote a separate paper note on — its whole architecture is basically a deep dive into exactly this idea). A normal row-oriented database stores an entire row together on disk, which is efficient for OLTP (“give me everything about this one order”) but wasteful for OLAP (“give me just the revenue column, summed, across 50 million orders”) — you’d end up reading every other column of every row just to throw it away. Column-oriented storage flips this: it stores each column together on disk instead, so an analytical query that only cares about revenue and region can skip reading every other column entirely, often making a scan over millions of rows dramatically faster.
Why this chapter earns its place before replication and partitioning
Reading this chapter clarified something for me about the replication and partitioning chapters I’d already written notes on: those chapters are about where copies of your data live and how it’s split across machines, but this chapter is about what’s actually happening on a single machine’s disk underneath all of that. A partitioned, replicated cluster of machines each running a badly-suited storage engine for the workload is still going to be slow — partitioning and replication solve “too much data/traffic for one machine,” not “the wrong data structure for this access pattern.” Both problems are real, and both need solving, but they’re genuinely separate layers of the same system.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 3: Storage and Retrieval.
Sau data model, cuốn sách đi sâu thêm một tầng nữa: tạm quên đi việc dữ liệu của bạn trông như thế nào với ứng dụng, vậy database thực sự lưu nó xuống một ổ đĩa vật lý thật như thế nào, theo cách cho phép nó tìm lại bất kỳ mẩu dữ liệu nào thật nhanh? Đây là chương mà cuối cùng tôi mới hiểu vì sao Postgres và Cassandra thực sự hành xử như hai loài khác nhau khi chịu tải, chứ không chỉ đơn giản là “cả hai đều là database.”
Database đơn giản nhất có thể, và vì sao nó tệ
Cuốn sách mở đầu bằng một database đồ chơi cố tình làm cho ngớ ngẩn: một script ghi mỗi lượt write thành một dòng mới nối vào cuối một file text, và tra cứu bằng cách quét toàn bộ file từ đầu mỗi lần. Ghi thì cực nhanh (chỉ nối thêm một dòng — chẳng cần tìm gì, chẳng cần sắp xếp lại gì). Đọc thì chậm khủng khiếp một khi file lớn lên, vì mỗi lượt tra cứu nghĩa là quét qua có thể hàng triệu dòng. Ví dụ đồ chơi này quan trọng vì nó thiết lập căng thẳng trung tâm của cả chương: ghi nhanh và đọc nhanh kéo thiết kế storage engine về hai hướng ngược nhau, và mọi storage engine thật ngoài đời chỉ là một sự thỏa hiệp khéo léo, cụ thể giữa hai thứ đó.
Cải tiến thật đầu tiên cuốn sách giới thiệu là index — một cấu trúc riêng, nhỏ hơn, cho bạn biết chính xác chỗ nào cần nhìn vào, để đọc không cần quét toàn bộ. Nhưng index không miễn phí: mỗi index bạn thêm vào làm việc ghi chậm đi một chút, vì giờ mỗi lượt ghi phải cập nhật cả index đó nữa, không chỉ nối thêm dữ liệu thô. Đây là một mô hình tư duy thực sự hữu ích mà trước đây tôi chưa có: mỗi index là một cược rằng bạn sẽ đọc field đó đủ thường xuyên để đáng trả một chút chi phí ghi trên mỗi lượt ghi, mãi mãi.
Hai họ storage engine: B-tree và LSM-tree
Phần thưởng thực sự của chương là so sánh trực diện hai thiết kế storage engine thống trị được dùng trong các database production thật ngày nay, và một khi thấy chúng cạnh nhau, rất nhiều câu hỏi “vì sao database này lại hành xử kiểu này” tôi giữ trong đầu bao năm nay tự nhiên được giải đáp:
B-tree — được dùng bởi PostgreSQL, MySQL/InnoDB, và Oracle, cùng nhiều cái khác — tổ chức dữ liệu trên đĩa thành các page kích thước cố định sắp xếp theo dạng cây, nơi mỗi lượt ghi tìm ra đúng page mà key đó thuộc về và cập nhật trực tiếp tại chỗ. Đây cùng ý tưởng cơ bản với tủ mục lục thư viện kiểu cũ: mọi thứ được giữ theo thứ tự nghiêm ngặt, dễ duyệt, nên cả “tìm đúng một cuốn sách này” lẫn “tìm mọi cuốn sách giữa hai mã số này” đều nhanh và dự đoán được. Cái giá là mỗi lượt ghi đều nghĩa là tìm một vị trí cụ thể trên đĩa vật lý và sửa nó ngay tại đó, mà — đặc biệt với ổ đĩa quay, và ở mức độ nhẹ hơn ngay cả với SSD — là một thao tác tương đối tốn kém gọi là seek, và nó xảy ra ở mỗi lượt ghi.
LSM-tree (log-structured merge-tree) — được dùng bởi Cassandra, RocksDB, LevelDB, và HBase — lấy ý tưởng log chỉ-nối-thêm từ đầu chương và biến nó thành thứ thực sự dùng được ở production. Lượt ghi mới đầu tiên đi vào một cấu trúc nhỏ, nhanh, trong bộ nhớ (memtable). Khi cái đó đầy, nó được flush xuống đĩa thành một file bất biến (SSTable), và một tiến trình chạy nền định kỳ gộp các SSTable cũ lại với nhau, loại bỏ những giá trị đã bị ghi đè hoặc xóa trong quá trình đó — gọi là compaction. Vì lượt ghi không bao giờ sửa gì tại chỗ — chúng chỉ nối thêm — thông lượng ghi có thể cao hơn B-tree rất nhiều. Cái giá lộ ra ở phía đọc: một lượt tra cứu, trong trường hợp xấu nhất, có thể phải kiểm tra memtable và vài SSTable trước khi tìm ra câu trả lời (hoặc xác nhận nó không tồn tại), dù các mẹo khéo léo như Bloom filter — một cấu trúc nhỏ, mang tính xác suất, có thể nhanh chóng nói “key này chắc chắn không có trong file này” mà không cần thực sự đọc file — lấy lại được kha khá chi phí đọc đó.
Phép so sánh đời thường đọng lại trong đầu tôi: B-tree giống như giữ đúng một tủ hồ sơ được xếp theo bảng chữ cái hoàn hảo, nơi mỗi tài liệu mới được cẩn thận chèn vào đúng vị trí của nó ngay lập tức — chính xác, nhưng chậm khi xếp từng tờ giấy mới. LSM-tree giống như ném mỗi tài liệu mới vào một chồng “hộp thư đến” luôn phình to, và chỉ định kỳ, ở hậu trường, mới sắp xếp và gộp các chồng đó thành những chồng gọn gàng hơn — nhận giấy mới thì nhanh, nhưng bạn có thể phải kiểm tra vài chồng trước khi chắc chắn đã tìm thấy (hoặc loại trừ) một tài liệu nào đó.
Không cái nào “tốt hơn” — nó quay lại đúng căng thẳng từ đầu chương. Các workload ghi liên tục và ít đọc hơn (hệ thống logging, dữ liệu time-series, pipeline phân tích nặng về ghi) thường thích LSM-tree. Các workload cần đọc nhanh, dự đoán được một cách nhất quán và chấp nhận ghi chậm hơn một chút thường tìm tới B-tree. Đây chính xác là lý do Cassandra (LSM-tree) là lựa chọn hàng đầu cho thứ như lưu một dòng dữ liệu cảm biến IoT liên tục, trong khi Postgres (B-tree) là lựa chọn hàng đầu cho số dư tài khoản trong hệ thống ngân hàng, nơi bạn đọc một tài khoản cụ thể thường xuyên hơn nhiều so với việc ghi hàng loạt.
OLTP vs OLAP: hai công việc hoàn toàn khác nhau mang chung một cái tên “database”
Phần cuối chương vẽ ra một ranh giới mà tôi vốn đã lờ mờ cảm nhận nhưng chưa bao giờ có từ vựng rõ ràng: OLTP (online transaction processing) so với OLAP (online analytic processing). Cả hai đều là “database,” nhưng chúng được tối ưu cho các pattern truy cập gần như ngược nhau:
- OLTP là thứ chạy ứng dụng thật của bạn theo thời gian thực — một người dùng kiểm tra số dư ngân hàng, một app thêm một món hàng vào giỏ. Mỗi query đụng vào một số ít dòng, nhưng có một số lượng khổng lồ query đồng thời diễn ra mỗi giây, từ nhiều người dùng khác nhau, mỗi người nhìn vào một lát cắt nhỏ xíu của dữ liệu.
- OLAP là thứ một chuyên viên phân tích kinh doanh chạy vào cuối quý để trả lời câu hỏi kiểu “tổng doanh thu của chúng ta theo từng khu vực trong hai năm qua là bao nhiêu?” Mỗi query có thể quét hàng triệu dòng, nhưng có tương đối ít query như vậy, thường được chạy bởi các nhà phân tích nội bộ chứ không phải người dùng cuối theo thời gian thực.
Sự phân chia này giải thích một lựa chọn thiết kế tôi từng thấy mà không hiểu vì sao: column-oriented storage (lưu theo cột), được dùng bởi các hệ thống như ClickHouse (tôi có viết một bài note riêng về paper này — toàn bộ kiến trúc của nó về cơ bản là đào sâu đúng ý tưởng này). Một database lưu theo dòng (row-oriented) thông thường lưu cả một dòng cùng nhau trên đĩa, hiệu quả cho OLTP (“cho tôi mọi thứ về đúng đơn hàng này”) nhưng lãng phí cho OLAP (“cho tôi chỉ mỗi cột revenue, cộng tổng lại, qua 50 triệu đơn hàng”) — bạn sẽ phải đọc mọi cột khác của mọi dòng chỉ để rồi vứt đi. Lưu theo cột đảo ngược điều này: nó lưu từng cột cùng nhau trên đĩa thay vào đó, nên một query phân tích chỉ quan tâm tới revenue và region có thể bỏ qua hoàn toàn việc đọc mọi cột khác, thường làm cho việc quét qua hàng triệu dòng nhanh hơn đáng kể.
Vì sao chương này xứng đáng đứng trước replication và partitioning
Đọc chương này làm rõ cho tôi một điều về các chương replication và partitioning mà tôi đã viết note trước đó: những chương đó nói về nơi các bản sao dữ liệu của bạn nằm và cách nó được chia ra trên nhiều máy, nhưng chương này nói về chuyện gì thực sự đang diễn ra trên đĩa của một máy đơn lẻ bên dưới tất cả những thứ đó. Một cluster máy đã được partition, replicate đầy đủ nhưng mỗi máy lại chạy một storage engine không hợp với workload vẫn sẽ chậm — partitioning và replication giải quyết “quá nhiều dữ liệu/traffic cho một máy,” không phải “sai cấu trúc dữ liệu cho pattern truy cập này.” Cả hai vấn đề đều có thật, và cả hai đều cần giải quyết, nhưng chúng thực sự là hai tầng riêng biệt của cùng một hệ thống.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.