~/blog/2026
DDIA Chapter 8: The Trouble with Distributed SystemsDDIA Chương 8: The Trouble with Distributed Systems

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 8: The Trouble with Distributed Systems.
After transactions, the book takes what felt like a step back — but is actually the most important chapter so far for understanding why everything before it (replication, partitioning, isolation) is as complicated as it is. This chapter doesn’t introduce a new technique. It’s an honest, occasionally unsettling inventory of everything that can quietly go wrong the moment your system spans more than one machine, and it left me with a healthy amount of paranoia about two things I used to take completely for granted: the network, and the clock.
The network lies to you, and it lies by omission
On a single machine, if a function call fails, you usually get a clear error immediately. Across a network, the book’s central, uncomfortable point is that you often get nothing — no error, no confirmation, just silence — and silence is fundamentally ambiguous. Did the request never arrive? Did it arrive and get processed, but the response got lost on the way back? Is the other machine just extremely slow right now? From the sending machine’s point of view, all three of these look absolutely identical: you sent something, and you haven’t heard back.
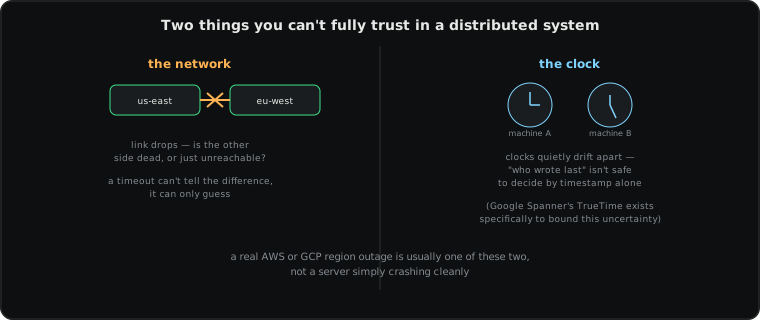
This is called a network partition, and real ones happen at real companies running real infrastructure — a misconfigured router, a severed undersea cable, a firewall rule change that accidentally blocks the wrong traffic. The book’s blunt conclusion: the only tool you actually have to distinguish “slow” from “dead” is a timeout, and a timeout is fundamentally a guess dressed up as a decision. Set it too short, and you’ll declare healthy, slightly-slow machines dead constantly, triggering unnecessary and disruptive failovers. Set it too long, and a genuinely dead machine keeps everyone else waiting far longer than necessary. There is no timeout value that is simultaneously always correct and always fast — you’re just picking where on that spectrum you’d rather be wrong.
Clocks don’t tell the truth either
This was the section that genuinely surprised me, because I’d always assumed “just check the timestamp” was a safe, boring way to figure out which of two events happened first. It isn’t. Every machine has its own physical clock, and these clocks drift — they run very slightly fast or slow compared to real time, and compared to each other, purely due to hardware imperfections. Systems try to correct for this using NTP (Network Time Protocol), periodically syncing to a reference clock over the network — but that correction itself travels over the same unreliable network described above, and can be delayed, or occasionally jump the clock backward or forward to fix a large drift.
The practical consequence the book hammers on: if two different machines each timestamp an event locally, and you later try to sort those events by comparing timestamps, you can get the order wrong, because the two clocks were never perfectly in sync to begin with. This is why “last write wins,” a strategy that sounds perfectly reasonable at first, is quietly dangerous in a distributed system — “last” according to whose clock? This exact problem is serious enough that Google built a specialized piece of infrastructure, TrueTime, specifically for their Spanner database — instead of pretending clocks are perfectly accurate, TrueTime reports a time as an honest range (“the real time is somewhere between X and Y”), and the system is designed to wait out that uncertainty window rather than gamble on a single, possibly-wrong timestamp.
Process pauses: your code can stop without you knowing
The third source of trouble is one I’d genuinely never considered: even a program that isn’t crashed and isn’t stuck in a network wait can simply stop running for an unpredictable stretch of time, for reasons entirely outside its own control. The book’s main example is garbage collection (GC) pauses — many programming languages periodically pause your entire program to clean up unused memory, and this pause can occasionally last much longer than expected under load. From every other machine’s perspective, a process that’s paused for a long GC cycle looks exactly like a process that’s crashed or a network that’s down — because, again, all they can observe is “I haven’t heard from it in a while.”
The unsettling implication: a distributed system has to be designed to tolerate a node going silent for an unpredictable amount of time and then coming back to life and resuming exactly where it left off, possibly still believing it holds a lock or a leadership role it actually lost while it was paused. This is why real systems use techniques like fencing tokens — a monotonically increasing number handed out with each lease or lock, so that if a paused node wakes up and tries to act on stale authority, the system can recognize its token is outdated and reject the action.
The honest lesson: assume nothing, verify everything
The chapter’s real conclusion isn’t a specific fix — it’s a change in posture. In a single-machine program, you can generally trust that if a function returns, it actually ran, and it ran once. In a distributed system, none of that is safe to assume: messages can be delayed, duplicated, or lost; clocks can’t be fully trusted to order events; and a node that seems dead might just be paused, and might wake back up believing something that’s no longer true. Every protocol covered in the chapters that follow — consensus and consistency especially — exists specifically to build reliable guarantees on top of this genuinely unreliable foundation, not to pretend the foundation is more solid than it is.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 8: The Trouble with Distributed Systems.
Sau transaction, cuốn sách có một bước nghe như lùi lại — nhưng thực ra đây là chương quan trọng nhất từ đầu tới giờ để hiểu vì sao mọi thứ trước đó (replication, partitioning, isolation) lại phức tạp đến vậy. Chương này không giới thiệu kỹ thuật mới nào. Nó là một bản kiểm kê thành thật, đôi khi khiến người đọc hơi bất an, về mọi thứ có thể âm thầm trục trặc ngay khi hệ thống của bạn trải rộng ra nhiều hơn một máy, và nó khiến tôi có một chút hoang mang lành mạnh về hai thứ tôi từng coi là hiển nhiên: mạng, và đồng hồ.
Mạng nói dối bạn, và nó nói dối bằng cách im lặng
Trên một máy đơn lẻ, nếu một hàm gọi thất bại, bạn thường nhận được lỗi rõ ràng ngay lập tức. Qua mạng, điểm trung tâm, hơi khó chịu mà cuốn sách nêu ra là bạn thường nhận được không gì cả — không lỗi, không xác nhận, chỉ có im lặng — và sự im lặng đó về bản chất là mơ hồ. Request có bao giờ tới nơi không? Nó có tới và được xử lý, nhưng phản hồi bị mất trên đường về? Hay máy kia chỉ đang cực kỳ chậm ngay lúc này? Từ góc nhìn của máy gửi, cả ba trường hợp này trông giống hệt nhau: bạn đã gửi thứ gì đó, và chưa nghe phản hồi.
Đây gọi là network partition (phân mảnh mạng), và những vụ thật xảy ra tại các công ty thật, vận hành hạ tầng thật — một router cấu hình sai, một dây cáp ngầm dưới biển bị đứt, một thay đổi quy tắc firewall vô tình chặn nhầm traffic. Kết luận thẳng thắn của cuốn sách: công cụ duy nhất bạn thực sự có để phân biệt “chậm” với “chết” là một timeout, và timeout về bản chất là một phỏng đoán được khoác áo thành một quyết định. Đặt nó quá ngắn, bạn sẽ liên tục tuyên bố những máy khỏe mạnh, chỉ hơi chậm là đã chết, kích hoạt những lần failover không cần thiết và gây rối. Đặt nó quá dài, một máy thực sự đã chết sẽ khiến mọi người khác chờ lâu hơn nhiều mức cần thiết. Không có giá trị timeout nào vừa luôn đúng vừa luôn nhanh — bạn chỉ đang chọn mình muốn sai ở đâu trên dải đó.
Đồng hồ cũng không nói thật
Đây là phần thực sự khiến tôi bất ngờ, vì tôi vẫn luôn cho rằng “cứ nhìn timestamp” là một cách an toàn, nhàm chán để biết sự kiện nào trong hai sự kiện xảy ra trước. Không phải vậy. Mỗi máy có đồng hồ vật lý riêng, và các đồng hồ này trôi — chúng chạy nhanh hơn hoặc chậm hơn một chút so với thời gian thật, và so với nhau, hoàn toàn do khiếm khuyết phần cứng. Hệ thống cố gắng sửa điều này bằng NTP (Network Time Protocol), định kỳ đồng bộ với một đồng hồ tham chiếu qua mạng — nhưng chính việc sửa đó cũng đi qua cùng mạng không đáng tin cậy đã nói ở trên, và có thể bị trễ, hoặc đôi khi làm đồng hồ nhảy lùi hoặc nhảy tiến để sửa một độ lệch lớn.
Hệ quả thực tế mà cuốn sách nhấn mạnh: nếu hai máy khác nhau mỗi máy đóng dấu thời gian một sự kiện cục bộ, và sau đó bạn cố sắp xếp các sự kiện đó bằng cách so sánh timestamp, bạn có thể sắp xếp sai thứ tự, vì hai đồng hồ đó chưa bao giờ đồng bộ hoàn hảo với nhau ngay từ đầu. Đây là lý do vì sao “last write wins” (ghi sau cùng thắng), một chiến lược nghe có vẻ hợp lý ban đầu, lại âm thầm nguy hiểm trong một hệ phân tán — “sau cùng” theo đồng hồ của ai? Vấn đề này nghiêm trọng đến mức Google đã xây riêng một hạ tầng chuyên dụng, TrueTime, dành riêng cho database Spanner của họ — thay vì giả vờ đồng hồ chính xác tuyệt đối, TrueTime báo cáo thời gian như một khoảng thành thật (“thời gian thật nằm đâu đó giữa X và Y”), và hệ thống được thiết kế để chờ hết khoảng bất định đó thay vì đánh cược vào một timestamp đơn lẻ, có thể sai.
Process pause: code của bạn có thể dừng lại mà bạn không hề biết
Nguồn rắc rối thứ ba là thứ tôi thực sự chưa bao giờ nghĩ tới: ngay cả một chương trình không crash và không bị kẹt chờ mạng vẫn có thể đơn giản là ngừng chạy trong một khoảng thời gian không đoán trước được, vì những lý do hoàn toàn nằm ngoài tầm kiểm soát của chính nó. Ví dụ chính trong sách là garbage collection (GC) pause — nhiều ngôn ngữ lập trình định kỳ tạm dừng toàn bộ chương trình của bạn để dọn dẹp bộ nhớ không dùng tới, và lần tạm dừng này đôi khi có thể kéo dài hơn nhiều so với dự kiến khi tải cao. Từ góc nhìn của mọi máy khác, một process đang tạm dừng vì một chu kỳ GC dài trông y hệt như một process đã crash hoặc một mạng đã sập — vì, một lần nữa, tất cả những gì họ quan sát được là “tôi chưa nghe được gì từ nó một lúc rồi.”
Hệ quả gây bất an: một hệ phân tán phải được thiết kế để chịu đựng việc một node im lặng trong một khoảng thời gian không đoán trước rồi sống lại và tiếp tục đúng chỗ nó đã dừng, có thể vẫn tin rằng nó đang giữ một lock hay vai trò leader mà thực ra nó đã mất trong lúc tạm dừng. Đây là lý do các hệ thống thật dùng kỹ thuật như fencing token — một con số tăng dần đơn điệu được cấp kèm mỗi lease hay lock, để nếu một node tạm dừng thức dậy và cố hành động dựa trên quyền hạn đã cũ, hệ thống có thể nhận ra token của nó đã lỗi thời và từ chối hành động đó.
Bài học thành thật: đừng giả định gì cả, xác minh mọi thứ
Kết luận thực sự của chương không phải một cách sửa cụ thể — nó là một sự thay đổi trong thái độ. Trong một chương trình chạy trên một máy đơn lẻ, bạn thường có thể tin rằng nếu một hàm trả về, nó thực sự đã chạy, và chạy đúng một lần. Trong một hệ phân tán, không điều nào trong số đó an toàn để giả định: message có thể bị trễ, bị nhân đôi, hoặc bị mất; đồng hồ không thể được tin tưởng hoàn toàn để sắp xếp sự kiện; và một node trông như đã chết có thể chỉ đang tạm dừng, và có thể sống lại với niềm tin vào điều gì đó không còn đúng nữa. Mọi giao thức được nói tới trong các chương tiếp theo — đặc biệt là consensus và consistency — tồn tại chính xác để xây dựng những đảm bảo đáng tin cậy trên nền của cái nền tảng thực sự không đáng tin cậy này, chứ không phải để giả vờ rằng nền tảng đó vững chắc hơn thực tế.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.