~/blog/2026
DDIA Chapter 7: TransactionsDDIA Chương 7: Transactions

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 7: Transactions.
This chapter opens Part II properly, and it’s about a word I’d been using casually for years without ever needing to define it precisely: transaction. Loosely, it means “a group of operations that the database treats as one single unit” — but the whole chapter is really about what that promise is actually worth, because it turns out different databases, and even the same database configured differently, promise wildly different things while all technically calling it a “transaction.”
ACID is four separate promises, not one word
Most people (myself included, until reading this properly) treat “ACID” as one blob meaning “the database is safe.” The book insists on splitting it into four genuinely distinct guarantees, and I found it useful to think about which specific bug each one actually prevents:
- Atomicity — a transaction either fully happens or fully doesn’t; there’s no “half-finished” state visible to anyone. If your code transfers money by subtracting from one account and adding to another, atomicity is what guarantees you never end up in a world where the money left one account but never arrived at the other, even if the server crashes halfway through.
- Consistency — here the book makes an important, easy-to-miss point: this is actually an application-level property, not something the database can enforce all on its own. The database can enforce specific rules you define (like “balances can’t go negative”), but “consistency” itself just means your data always satisfies whatever invariants your application cares about — the database is a tool that helps you keep that promise, not something that magically knows what your invariants are.
- Isolation — concurrent transactions shouldn’t be able to see each other’s half-finished work. This is the guarantee that gets the most attention in the chapter, because it’s the one with the most ways to go subtly, dangerously wrong.
- Durability — once a transaction says “committed,” it stays committed, even if the machine loses power one second later.
Where isolation actually breaks down
The chapter’s real substance is a tour of specific ways concurrent transactions can step on each other, and honestly, several of these were bugs I would not have predicted on my own:
Dirty reads — one transaction sees a change from another transaction that hasn’t been committed yet, and might get rolled back. Imagine seeing your bank balance already reflect a transfer that then gets cancelled a moment later — you briefly saw money that was never actually real.
Lost updates — two transactions read the same value, both decide what to write based on that value, and one write silently overwrites the other, throwing away one of the two updates. The classic version of this, which the book uses and which I found genuinely clarifying:
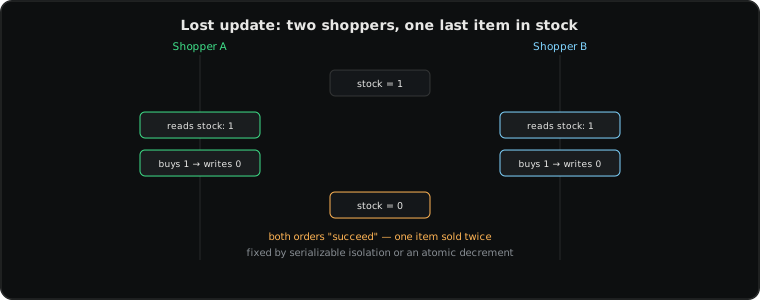
Two customers both check a product page at nearly the same instant, both see “1 in stock,” both click buy. If the database naively lets each transaction read the stock count, decide to subtract one, and write the new value back — without anything stopping the second write from blindly overwriting the first — you end up having sold the same last unit twice. Nobody’s individual code was wrong; the interleaving was the bug.
Write skew — a subtler cousin of lost updates, where two transactions read overlapping data, each makes a decision that’s individually fine given what it read, but the combination violates a rule neither transaction technically broke on its own. The book’s example: a hospital requires at least one doctor on call at all times; two doctors, seeing “there are currently two of us on call,” each independently decide it’s safe for them to go off call — and now there are zero.
Isolation levels: how much protection you’re actually buying
Because preventing every one of these perfectly, all the time, is expensive, real databases offer a menu of isolation levels, and the honest, slightly uncomfortable truth the book states plainly: many databases don’t default to the strongest one, because the strongest one is slower.
- Read committed — the weakest level covered in depth; it just guarantees you’ll never see another transaction’s uncommitted changes (no dirty reads). It does nothing to stop lost updates or write skew.
- Snapshot isolation — each transaction sees a consistent snapshot of the database as it looked at the moment the transaction started, so it’s immune to dirty reads and most read-related weirdness. It’s a very popular default (Postgres calls its version of this “repeatable read”) because it’s much faster than full serializability, but it still doesn’t fully protect against write skew.
- Serializable — the strongest level: the database guarantees the result is as if every transaction ran one at a time, in some order, with zero overlap, even though under the hood they might actually run concurrently for performance. This is the only level that genuinely closes every one of the bugs above, and it’s also the most expensive, because achieving that guarantee under real concurrent load takes real work — either literally running things one at a time, or detecting and aborting/retrying transactions that would have conflicted.
The lesson that stuck with me: “my database uses transactions” tells you almost nothing on its own. The actual question that matters is “which isolation level, specifically, and did anyone deliberately choose it, or is it just whatever the database defaulted to?”
Why this chapter sets up everything after it
Reading this right after storage engines and right before the more distributed-systems-heavy chapters made the sequencing click for me: this chapter is entirely about correctness on a single machine (or a single database, at least) under concurrent access. The much harder version of this same problem — transactions that span multiple machines, where a network can fail in the middle — is exactly what makes the next couple of chapters (the trouble with distributed systems and consistency and consensus) so much harder than this one. You can’t really appreciate why distributed transactions are painful until you’ve seen how much careful engineering it already takes to get transactions right on one honest, reliable machine.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 7: Transactions.
Chương này chính thức mở đầu Phần II, và nó nói về một từ tôi vẫn dùng một cách tùy tiện bao năm nay mà chưa bao giờ cần định nghĩa chính xác: transaction (giao dịch). Nói một cách lỏng lẻo, nó nghĩa là “một nhóm thao tác mà database coi là một khối duy nhất” — nhưng cả chương thực chất nói về việc lời hứa đó thực sự đáng giá bao nhiêu, vì hóa ra các database khác nhau, và ngay cả cùng một database được cấu hình khác nhau, hứa hẹn những thứ khác nhau rất nhiều trong khi về mặt kỹ thuật đều gọi đó là “transaction.”
ACID là bốn lời hứa riêng biệt, không phải một từ
Hầu hết mọi người (kể cả tôi, cho tới khi đọc kỹ chương này) coi “ACID” là một khối duy nhất nghĩa là “database an toàn.” Cuốn sách khăng khăng tách nó thành bốn đảm bảo thực sự khác nhau, và tôi thấy hữu ích khi nghĩ về việc mỗi cái thực sự ngăn con bug cụ thể nào:
- Atomicity (tính nguyên tử) — một transaction hoặc xảy ra hoàn toàn, hoặc không xảy ra chút nào; không có trạng thái “làm dở dang” nào lộ ra cho ai thấy. Nếu code của bạn chuyển tiền bằng cách trừ từ một tài khoản và cộng vào tài khoản khác, atomicity là thứ đảm bảo bạn không bao giờ rơi vào tình huống tiền đã rời khỏi một tài khoản nhưng chưa bao giờ tới tài khoản kia, kể cả khi server crash giữa chừng.
- Consistency (tính nhất quán) — đây là chỗ cuốn sách đưa ra một điểm quan trọng, dễ bỏ sót: đây thực ra là một tính chất ở tầng ứng dụng, không phải thứ database có thể tự mình đảm bảo hoàn toàn. Database có thể ép các quy tắc cụ thể bạn định nghĩa (như “số dư không được âm”), nhưng “consistency” tự nó chỉ nghĩa là dữ liệu của bạn luôn thỏa mãn bất kỳ bất biến nào ứng dụng của bạn quan tâm — database là công cụ giúp bạn giữ lời hứa đó, không phải thứ tự nhiên biết bất biến của bạn là gì.
- Isolation (tính cô lập) — các transaction chạy đồng thời không nên thấy được công việc làm dở của nhau. Đây là đảm bảo được chương này chú ý nhiều nhất, vì nó có nhiều cách âm thầm, nguy hiểm để sai nhất.
- Durability (tính bền vững) — một khi transaction báo “đã commit,” nó vẫn ở trạng thái đã commit, kể cả khi máy mất điện đúng một giây sau đó.
Chỗ isolation thực sự sụp đổ
Nội dung thực chất của chương là một chuyến tham quan các cách cụ thể mà các transaction đồng thời có thể giẫm chân lên nhau, và thành thật mà nói, vài cái trong số này là bug tôi sẽ không tự đoán ra được:
Dirty reads (đọc bẩn) — một transaction thấy được thay đổi từ một transaction khác chưa được commit, và thay đổi đó có thể bị rollback sau đó. Hãy tưởng tượng thấy số dư ngân hàng của bạn đã phản ánh một lượt chuyển tiền rồi bị hủy ngay sau đó — bạn đã thấy thoáng qua số tiền chưa bao giờ thực sự có thật.
Lost updates (mất cập nhật) — hai transaction đọc cùng một giá trị, cả hai đều quyết định ghi gì đó dựa trên giá trị đó, và một lượt ghi âm thầm ghi đè lên lượt kia, làm mất đi một trong hai cập nhật. Phiên bản kinh điển của việc này, mà cuốn sách dùng và tôi thấy thực sự làm sáng tỏ vấn đề:
Hai khách hàng cùng xem một trang sản phẩm gần như cùng lúc, cả hai thấy “còn 1 trong kho,” cả hai đều bấm mua. Nếu database ngây thơ để mỗi transaction đọc số lượng tồn kho, quyết định trừ đi một, rồi ghi giá trị mới trở lại — mà không có gì ngăn lượt ghi thứ hai mù quáng ghi đè lên lượt đầu — bạn sẽ kết thúc bằng việc bán đúng đơn vị cuối cùng đó hai lần. Không đoạn code riêng lẻ nào sai cả; chính cách chúng xen kẽ nhau mới là bug.
Write skew (lệch ghi) — một người anh em họ tinh vi hơn của lost update, nơi hai transaction đọc dữ liệu chồng lấn nhau, mỗi transaction đưa ra một quyết định riêng lẻ là ổn dựa trên những gì nó đọc được, nhưng kết hợp lại thì vi phạm một quy tắc mà không transaction nào về mặt kỹ thuật tự mình phá vỡ. Ví dụ trong sách: một bệnh viện yêu cầu luôn có ít nhất một bác sĩ trực; hai bác sĩ, thấy “hiện đang có hai người trong chúng ta trực,” mỗi người độc lập quyết định mình có thể an toàn rời ca trực — và giờ còn lại số không.
Isolation level: bạn thực sự đang mua bao nhiêu sự bảo vệ
Vì ngăn chặn hoàn hảo mọi thứ trên, mọi lúc, là tốn kém, các database thật cung cấp một thực đơn isolation level, và sự thật thành thật, hơi khó chịu mà cuốn sách nói thẳng: nhiều database không mặc định dùng mức mạnh nhất, vì mức mạnh nhất chậm hơn.
- Read committed — mức yếu nhất được nói kỹ; nó chỉ đảm bảo bạn sẽ không bao giờ thấy thay đổi chưa commit của transaction khác (không có dirty read). Nó không làm gì để ngăn lost update hay write skew.
- Snapshot isolation — mỗi transaction thấy một bức ảnh chụp nhất quán của database đúng như nó trông vào thời điểm transaction bắt đầu, nên nó miễn nhiễm với dirty read và hầu hết sự kỳ lạ liên quan tới đọc. Đây là một lựa chọn mặc định rất phổ biến (Postgres gọi phiên bản của nó là “repeatable read”) vì nó nhanh hơn nhiều so với serializable đầy đủ, nhưng nó vẫn không bảo vệ hoàn toàn khỏi write skew.
- Serializable — mức mạnh nhất: database đảm bảo kết quả như thể mọi transaction chạy từng cái một, theo một thứ tự nào đó, không hề chồng lấn, kể cả khi bên dưới chúng có thể thực sự chạy đồng thời để tăng hiệu năng. Đây là mức duy nhất thực sự đóng hết mọi con bug ở trên, và cũng là mức tốn kém nhất, vì đạt được đảm bảo đó dưới tải đồng thời thật đòi hỏi công sức thật — hoặc thực sự chạy từng cái một, hoặc phát hiện và hủy/thử lại các transaction lẽ ra sẽ xung đột.
Bài học đọng lại trong tôi: “database của tôi dùng transaction” tự nó gần như không nói lên điều gì. Câu hỏi thực sự quan trọng là “isolation level cụ thể nào, và có ai chủ động chọn nó không, hay chỉ là bất kỳ thứ gì database mặc định?”
Vì sao chương này thiết lập nền cho mọi thứ sau nó
Đọc chương này ngay sau storage engine và ngay trước các chương thiên về hệ phân tán nhiều hơn khiến trình tự này sáng tỏ với tôi: chương này hoàn toàn nói về tính đúng đắn trên một máy đơn lẻ (hoặc ít nhất một database đơn lẻ) khi bị truy cập đồng thời. Phiên bản khó hơn nhiều của cùng vấn đề này — transaction trải trên nhiều máy, nơi mạng có thể chết giữa chừng — chính xác là thứ khiến vài chương tiếp theo (rắc rối của hệ phân tán và consistency và consensus) khó hơn chương này rất nhiều. Bạn không thể thực sự thấm được vì sao distributed transaction lại đau đầu đến vậy cho tới khi thấy đã cần bao nhiêu công sức kỹ thuật cẩn thận chỉ để làm đúng transaction trên một máy trung thực, đáng tin cậy.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.