~/blog/2026
DDIA Chapter 4: Encoding and EvolutionDDIA Chương 4: Encoding and Evolution

Book: Designing Data-Intensive Applications by Martin Kleppmann — Chapter 4: Encoding and Evolution.
This chapter closes out Part I of the book, and it’s about a problem that sounds almost too obvious to write a whole chapter on: how do you turn an in-memory object — a struct, a class instance, whatever your programming language calls it — into bytes you can send over a network or write to disk, and then turn it back into an object later? That’s called encoding (or serialization). The reason it deserves a full chapter is the second half of the title: evolution — what happens when the shape of that data needs to change, but you can’t update every single reader and writer of it at exactly the same instant.
Why “just update everything at once” is never actually an option
This is the part of the chapter that reframed the whole topic for me. In any system beyond a toy project, you basically never get to update all your code and all your data at the same instant:
- Server-side rolling deploys — when you deploy new code to a fleet of, say, a hundred servers, you don’t take them all down at once (that would mean an outage). You update them a few at a time, which means for some window of time, old code and new code are both running simultaneously, and they might both be reading and writing the exact same data or exchanging messages with each other.
- Client-side apps — a user might not update their mobile app for months. The new server has to keep working correctly with old app versions still in the wild, sometimes for years.
- Data outlives code — a row written to a database five years ago, by code that no longer exists, still has to be readable by whatever code is running today.
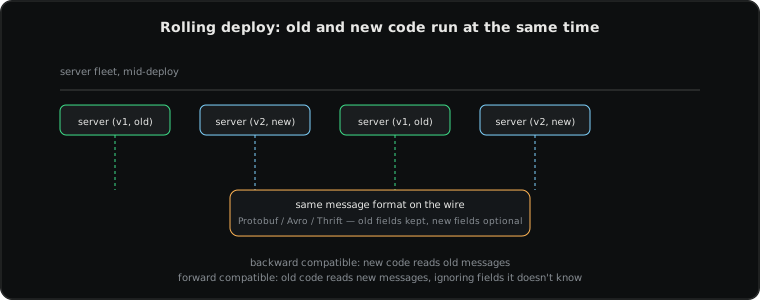
Once I saw it framed this way, I realized “backward compatibility” isn’t some extra nice-to-have feature — it’s a mechanical necessity of how real deployments physically work. You can’t will your way out of the fact that old and new code overlap in time; you can only design your encoding so that the overlap doesn’t break anything.
Two compatibility directions, and why you need both
The book defines two distinct kinds of compatibility, and I found it useful to think of them as two separate questions rather than one blurry concept:
- Backward compatibility — can newer code read data that was written by older code? This is usually the easier one: newer code typically knows about old fields and can just keep supporting them.
- Forward compatibility — can older code read data written by newer code? This is the trickier direction, because old code, by definition, doesn’t know about fields that didn’t exist yet when it was written. The old code has to be written defensively enough to just ignore fields it doesn’t recognize, rather than crashing on them.
During a rolling deploy, you genuinely need both at once, in both directions, because at any given moment some machines are old and some are new, and they’re all talking to each other simultaneously.
Text formats vs. binary formats
The chapter walks through a few families of encoding formats, and the tradeoff pattern is one I now recognize everywhere:
Text-based formats — JSON, XML, CSV. Their big advantage is that they’re human-readable — you can open one in a plain text editor and understand it, which is genuinely valuable for debugging. Their downside is that they’re verbose (field names get repeated in every single record) and somewhat ambiguous about types (JSON, for instance, famously doesn’t distinguish integers from floating-point numbers, and has no native way to represent large numbers precisely — a real, documented source of bugs when large IDs get silently rounded).
Binary formats with a schema — Protocol Buffers (Google), Thrift (originally Facebook), Avro (Apache, heavily used inside the Kafka/LinkedIn ecosystem). Instead of repeating field names in every message, you define a schema once — “field 1 is name, a string; field 2 is age, an integer” — and the encoded bytes just contain the values in a known order, referencing fields by a short numeric tag instead of spelling out the name every time. This is dramatically smaller on the wire and faster to parse, at the cost of needing that schema definition to make sense of the raw bytes at all.
What made schemas click for me as more than “a way to save bytes”: a schema is also a contract. It’s the thing that lets Protobuf and Avro define precise, checkable rules for what counts as a backward- or forward-compatible change — for example, you’re generally allowed to add a new optional field (old readers just skip it, satisfying forward compatibility) but you’re generally not allowed to change a field’s type or reuse someone else’s old field number, because that silently corrupts data for whichever version doesn’t expect it.
Dataflow: how encoded data actually travels
The last part of the chapter looks at the different paths encoded data takes through a real system, and each path has its own compatibility expectations:
- Through a database — you write a row today, and it might be read years from now by a completely different version of your application. This is backward compatibility stretched out over a very long timescale, which is why database schema migrations are treated so carefully in real teams — you’re not just changing today’s code, you’re committing to how every future version of your code will need to interpret today’s write.
- Through service calls (REST, RPC) — one service calls another over the network, and the two services are very likely running different code versions at any given time, especially in a company running dozens of independently-deployed microservices. Both directions of compatibility matter constantly, because you rarely control exactly when every other team deploys their side.
- Through a message queue (like Kafka) — a message gets written once by a producer and might be read later by several different consumers, each potentially running different code versions, and the message itself might sit in the queue for a while before anyone reads it. This is arguably the trickiest case, because the producer often doesn’t even know who all the eventual readers are, or what version of the code they’ll be running when they finally read it.
Why this closes out Part I so well
Looking back at the four chapters so far — reliability and scalability, data models, storage engines, and now encoding — I can see why the book groups them as “foundations.” They’re all about a single machine’s honest relationship with its own data: how to survive faults, how to shape data, how to store it, and now, how to let that shape safely change over time. Everything from here on — replication, partitioning, transactions, consensus — is about coordinating multiple machines, and none of that works if a single machine can’t even reliably read data that a slightly different version of itself wrote yesterday.
Sách: Designing Data-Intensive Applications của Martin Kleppmann — Chương 4: Encoding and Evolution.
Chương này khép lại Phần I của cuốn sách, và nó nói về một vấn đề nghe có vẻ hiển nhiên đến mức khó tin lại cần cả một chương: làm sao biến một object trong bộ nhớ — một struct, một instance của class, tùy ngôn ngữ lập trình bạn gọi nó là gì — thành byte để gửi qua mạng hoặc ghi xuống đĩa, rồi sau đó biến ngược lại thành object? Đó gọi là encoding (hay serialization). Lý do nó xứng đáng cả một chương nằm ở nửa sau của tiêu đề: evolution (tiến hóa) — chuyện gì xảy ra khi hình dạng của dữ liệu đó cần thay đổi, nhưng bạn không thể cập nhật mọi reader và writer của nó đúng cùng một khoảnh khắc.
Vì sao “cứ cập nhật hết mọi thứ cùng lúc” không bao giờ thực sự là một lựa chọn
Đây là phần khiến tôi nhìn lại toàn bộ chủ đề này theo cách khác. Trong bất kỳ hệ thống nào vượt ra khỏi một dự án đồ chơi, bạn về cơ bản không bao giờ được cập nhật toàn bộ code và toàn bộ dữ liệu đúng cùng một khoảnh khắc:
- Rolling deploy phía server — khi bạn deploy code mới lên một hạm đội, giả sử một trăm server, bạn không tắt hết chúng cùng lúc (như vậy sẽ gây downtime). Bạn cập nhật từng ít một, nghĩa là trong một khoảng thời gian nào đó, code cũ và code mới cùng chạy song song, và chúng có thể cùng đọc, ghi đúng một dữ liệu hoặc trao đổi tin nhắn với nhau.
- Ứng dụng phía client — một người dùng có thể không cập nhật app di động của họ trong nhiều tháng. Server mới phải tiếp tục hoạt động đúng với các phiên bản app cũ vẫn đang tồn tại ngoài kia, đôi khi hàng năm trời.
- Dữ liệu sống lâu hơn code — một dòng được ghi vào database năm năm trước, bởi code giờ không còn tồn tại, vẫn phải đọc được bởi bất kỳ code nào đang chạy hôm nay.
Khi nhìn theo cách đóng khung này, tôi nhận ra “backward compatibility” (tương thích ngược) không phải một tính năng phụ hay ho nào đó — nó là một yêu cầu cơ học bắt buộc từ cách các đợt deploy thật vận hành về mặt vật lý. Bạn không thể ước cho việc code cũ và mới chồng lấn nhau về thời gian biến mất; bạn chỉ có thể thiết kế encoding của mình sao cho sự chồng lấn đó không phá vỡ điều gì.
Hai chiều tương thích, và vì sao bạn cần cả hai
Cuốn sách định nghĩa hai loại tương thích riêng biệt, và tôi thấy hữu ích khi nghĩ về chúng như hai câu hỏi tách biệt thay vì một khái niệm mơ hồ:
- Backward compatibility (tương thích ngược) — code mới hơn có đọc được dữ liệu do code cũ hơn ghi ra không? Đây thường là chiều dễ hơn: code mới thường biết về các field cũ và có thể cứ tiếp tục hỗ trợ chúng.
- Forward compatibility (tương thích xuôi) — code cũ hơn có đọc được dữ liệu do code mới hơn ghi ra không? Đây là chiều hóc búa hơn, vì theo định nghĩa, code cũ không biết về những field chưa tồn tại vào lúc nó được viết. Code cũ phải được viết đủ phòng thủ để chỉ bỏ qua các field nó không nhận ra, thay vì bị crash vì chúng.
Trong một đợt rolling deploy, bạn thực sự cần cả hai chiều cùng lúc, vì tại bất kỳ thời điểm nào cũng có máy cũ và máy mới, và tất cả chúng đều đang nói chuyện với nhau đồng thời.
Định dạng text vs. định dạng binary
Chương này đi qua vài họ định dạng encoding, và pattern đánh đổi ở đây là thứ giờ tôi nhận ra ở khắp mọi nơi:
Định dạng dựa trên text — JSON, XML, CSV. Ưu điểm lớn của chúng là con người đọc được — bạn có thể mở nó bằng một trình soạn thảo text đơn giản và hiểu được, điều này thực sự quý giá khi debug. Nhược điểm là chúng dài dòng (tên field bị lặp lại trong mỗi bản ghi) và có phần mơ hồ về kiểu dữ liệu (JSON, chẳng hạn, nổi tiếng là không phân biệt số nguyên với số thực, và không có cách nào native để biểu diễn số lớn một cách chính xác — một nguồn bug thật, đã được ghi nhận, khi ID lớn bị âm thầm làm tròn).
Định dạng binary có schema — Protocol Buffers (Google), Thrift (ban đầu từ Facebook), Avro (Apache, được dùng rất nhiều trong hệ sinh thái Kafka/LinkedIn). Thay vì lặp lại tên field trong mỗi message, bạn định nghĩa một schema đúng một lần — “field 1 là name, kiểu string; field 2 là age, kiểu integer” — và byte được encode chỉ chứa giá trị theo một thứ tự đã biết, tham chiếu field bằng một tag số ngắn thay vì viết ra tên đầy đủ mỗi lần. Cách này nhỏ hơn đáng kể khi truyền đi và parse nhanh hơn, đổi lại là cần có định nghĩa schema đó thì mới hiểu được byte thô là gì.
Điều khiến schema thực sự “sáng” ra với tôi, hơn cả “một cách tiết kiệm byte”: schema còn là một hợp đồng. Đó là thứ cho phép Protobuf và Avro định nghĩa các quy tắc chính xác, kiểm chứng được về việc thay đổi nào được tính là tương thích ngược hay tương thích xuôi — ví dụ, bạn thường được phép thêm một field tùy chọn mới (reader cũ chỉ bỏ qua nó, thỏa mãn tương thích xuôi) nhưng bạn thường không được phép đổi kiểu của một field hoặc tái sử dụng số field cũ của ai đó khác, vì điều đó âm thầm làm hỏng dữ liệu cho bất kỳ phiên bản nào không lường trước điều đó.
Dataflow: dữ liệu đã encode thực sự di chuyển như thế nào
Phần cuối chương nhìn vào các con đường khác nhau mà dữ liệu đã encode đi qua trong một hệ thống thật, và mỗi con đường có kỳ vọng tương thích riêng:
- Qua database — bạn ghi một dòng hôm nay, và nó có thể được đọc nhiều năm sau bởi một phiên bản ứng dụng hoàn toàn khác. Đây là tương thích ngược kéo dài trên một khung thời gian rất dài, đó là lý do vì sao migration schema database được các team thật xử lý cẩn thận đến vậy — bạn không chỉ đang đổi code hôm nay, bạn đang cam kết cách mọi phiên bản code tương lai sẽ cần diễn giải lượt ghi hôm nay.
- Qua service call (REST, RPC) — một service gọi một service khác qua mạng, và hai service đó rất có thể đang chạy các phiên bản code khác nhau tại bất kỳ thời điểm nào, đặc biệt trong một công ty vận hành hàng chục microservice deploy độc lập. Cả hai chiều tương thích đều quan trọng liên tục, vì bạn hiếm khi kiểm soát chính xác lúc nào team khác deploy phía của họ.
- Qua message queue (như Kafka) — một message được ghi đúng một lần bởi producer và có thể được đọc sau đó bởi nhiều consumer khác nhau, mỗi consumer có thể chạy phiên bản code khác nhau, và bản thân message có thể nằm trong queue một thời gian trước khi ai đó đọc nó. Đây có lẽ là trường hợp hóc búa nhất, vì producer thường thậm chí không biết hết ai sẽ là người đọc cuối cùng, hay họ sẽ chạy phiên bản code nào khi cuối cùng đọc nó.
Vì sao chương này khép lại Phần I một cách trọn vẹn
Nhìn lại bốn chương đã qua — reliability và scalability, data model, storage engine, và giờ là encoding — tôi hiểu vì sao cuốn sách nhóm chúng lại thành “nền tảng.” Tất cả đều nói về mối quan hệ trung thực của một máy đơn lẻ với chính dữ liệu của nó: cách sống sót qua sự cố, cách định hình dữ liệu, cách lưu trữ nó, và giờ là cách để hình dạng đó thay đổi an toàn theo thời gian. Mọi thứ từ đây trở đi — replication, partitioning, transaction, consensus — đều nói về việc phối hợp nhiều máy, và không điều nào trong số đó hoạt động được nếu một máy đơn lẻ còn không thể đọc đáng tin cậy dữ liệu mà một phiên bản hơi khác của chính nó đã ghi hôm qua.
~/comments
Didn't follow a part of this? Ask below — comments use your GitHub account, via GitHub Discussions.Có chỗ nào chưa rõ? Hỏi ngay bên dưới — bình luận dùng tài khoản GitHub của bạn, thông qua GitHub Discussions.